この記事のポイント
レガシーシステムがAI活用を阻む原因は、AIモデルではなく「データ層・連携層・ロジック層・ガバナンス層」の4層にあります。AIがPoC止まりになるのは、PoCと本番でデータの扱い方がまったく違うためです。本記事の12項目のチェックで、自社のボトルネックとなっている層を特定できます。全面刷新をしなくても、詰まっている層から順に手を打てば壁は越えられます。
「生成AIを導入したのに、PoCから先に進まない」。その原因の多くは、AIモデルではなくレガシーシステムにあります。レガシーシステムがデータ活用やAI活用の壁になるのは、データが「取り出せない・意味がわからない・つながらない・統制できない」という構造的な問題を抱えているからです。
Gartnerは、AI-readyデータ(AIに適した形で整備されたデータ)の裏付けがないAIプロジェクトの60%が、2026年までに中止されると予測しています(Gartner, 2025年2月)。日本でも経済産業省のレガシーシステムモダン化委員会総括レポートが、約6割の企業にレガシーシステムが残存しており、それが生成AIなど最新技術との連携・組み込みを妨げていると指摘しています。
本記事では、この壁を4つの層に分解し、PoC止まりの構造、AIレディ診断、層別の刷新アプローチ、経営層への説明の仕方までを解説します。レガシーシステム全体のリスクと刷新のタイミングについては、「レガシーシステムのリスク、先延ばしのコスト、そして刷新すべき時期」をご覧ください。レガシーシステムの定義や代表的な課題から確認したい方は、「レガシーシステムとは?定義・最新の解決策と5つの課題」もあわせてご覧ください。
AI活用が「PoC止まり」になる本当の理由は、レガシーシステムにある
多くの企業で、AIのPoC(概念実証)自体は成功します。問題が起こるのは、その成果を本番業務に広げようとした段階です。まずは、よくある失敗パターンから見ていきましょう。
PoCは成功するのに本番で止まる — よくある3つのパターン
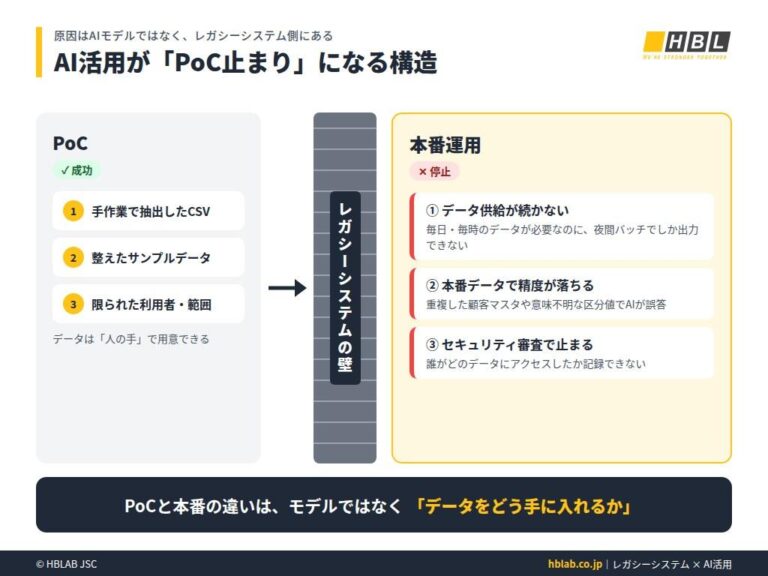
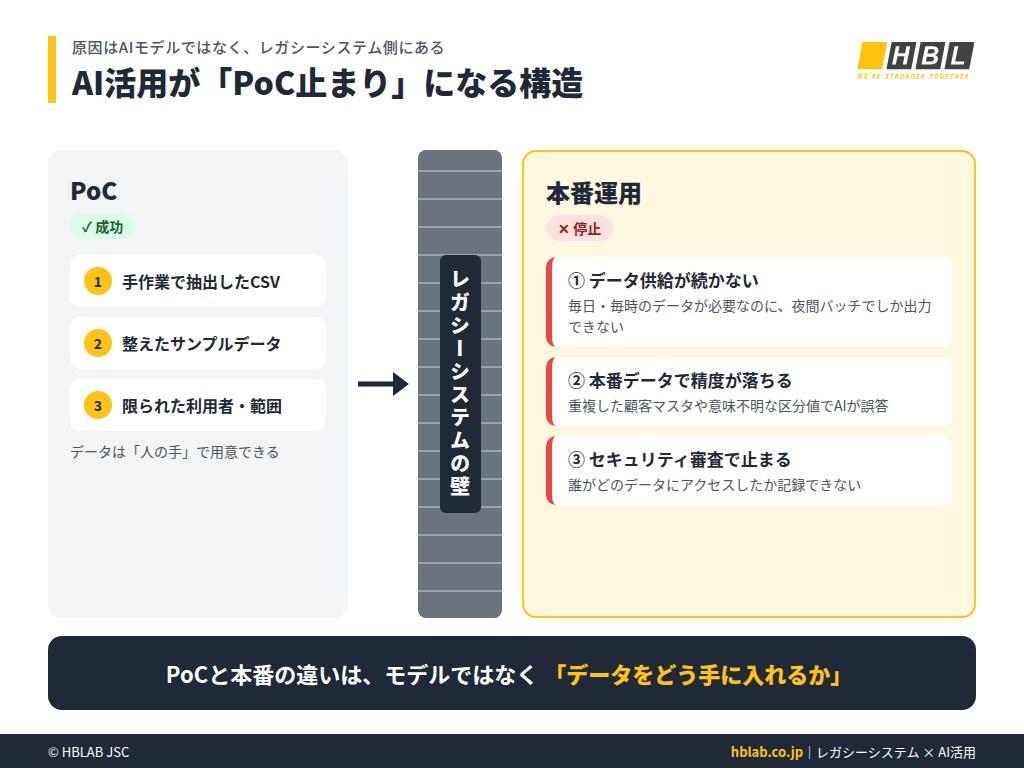
PoCと本番の違いは、モデルではなく「データをどう手に入れるか」にあります。現場で繰り返し起きているのは、次の3パターンです。
- データ供給が続かない:PoCでは、担当者が手作業で抽出したCSVデータで学習させることができます。しかし本番では日次・時間単位で最新のデータが必要になり、夜間バッチでしか出力できないレガシーシステムでは供給が追いつきません。
- 本番データで精度が落ちる:整えたサンプルデータでは高精度だったモデルが、実データでは重複した顧客マスタや意味が不明な区分値に引きずられ、誤った回答を返し始めます。
- セキュリティ審査で止まる:「誰がどのデータにアクセスしたか」を記録できないため、情報セキュリティ部門から本番利用の承認が下りません。
いずれのパターンも、AIモデルを変えても解決しません。原因がレガシーシステム側にあるからです。
数字で見る:AI-readyデータの不足がAIプロジェクトを止めている
こうした現象は個別企業の問題ではありません。各種の調査データを見ると、産業全体に共通する構造的な課題であることがわかります。
- 60%:AI-readyデータの裏付けがないAIプロジェクトのうち、2026年までに中止されると予測される割合(Gartner)
- 63%:AIに適したデータ管理の仕組みを「持っていない」または「わからない」と答えた組織の割合(Gartner、データ管理責任者1,203名への調査)
- 約6割:レガシーシステムが残存しているユーザー企業の割合(経済産業省 レガシーシステムモダン化委員会)
- 約5割:生成AIに前向きに取り組む(導入済・試験利用・検討中)日本企業の割合。米国は約8割、ドイツは約7割(IPA「DX動向2025」)
生成AI・AIエージェント時代に「壁」が高くなった理由
実は、レガシーシステムの壁はAIの進化とともに高くなっています。従来のBI(ビジネスインテリジェンス)なら、前日の夜間バッチで作ったデータで十分でした。
一方、RAG(検索拡張生成)やAIエージェントが求める条件は、はるかに厳しいものです。
| 観点 | 従来のBI・分析 | 生成AI・RAG・AIエージェント |
|---|---|---|
| データの鮮度 | 前日のバッチで十分 | リアルタイムに近い更新が必要 |
| アクセス方法 | 一括エクスポート | APIによる都度アクセス |
| 必要な情報 | 数値データ中心 | 数値+意味・文脈(メタデータ) |
| 権限管理 | レポート単位 | 問い合わせ・操作ごと |
| システムへの操作 | 参照のみ | 登録・更新などの「実行」も含む |
特にAIエージェントは、システムを「読む」にとどまらず「操作する」ことまでが前提です。画面操作とバッチ処理しか受け付けないシステムでは、AIエージェントを活用できません。
レガシーシステムがデータ・AI活用を阻む「4つの層」
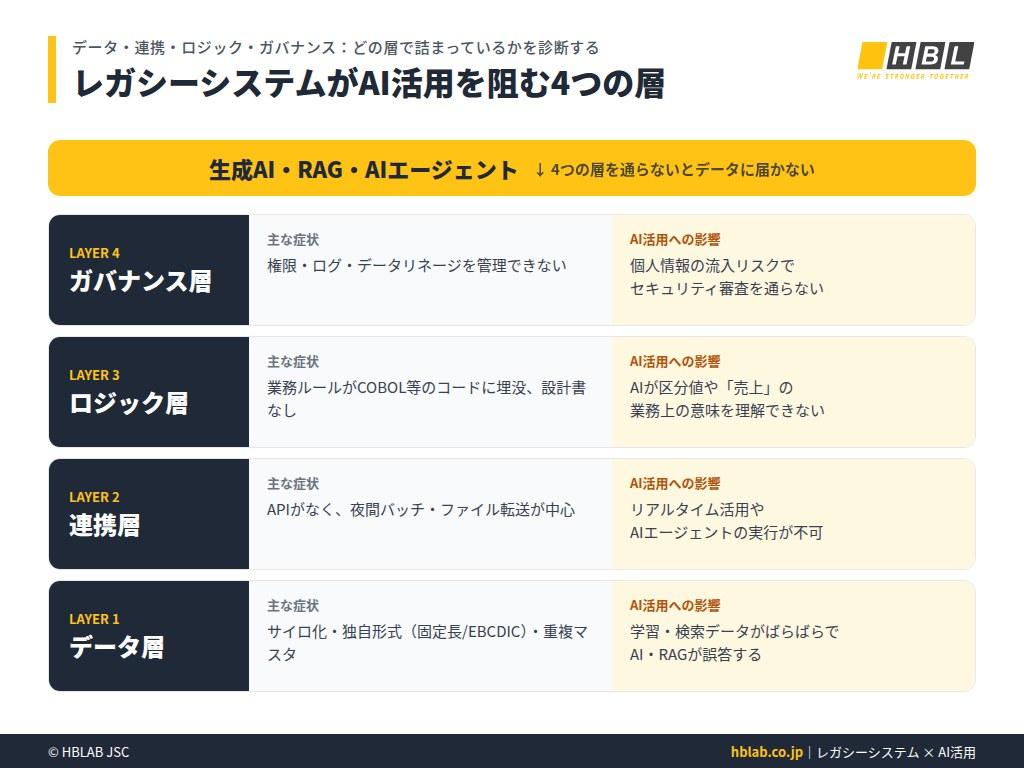
では、レガシーシステムの何がAI活用を止めているのでしょうか。症状はさまざまですが、原因は次の4つの層に整理できます。どの層で詰まっているかがわかれば、打ち手も明確になります。
データ層:サイロ化・独自フォーマット・品質の問題
最初の壁は、データそのものです。データ活用の出発点であるこの層でつまずくと、その先のAI活用も進みません。長年使われてきたシステムには、AIがそのまま扱えないデータが蓄積しています。
- サイロ化:販売・在庫・会計などのデータが部門ごとのシステムに分散し、横断的に分析できない
- 独自フォーマット:固定長ファイル、EBCDICなどの古い文字コード、和暦の日付など、変換なしでは読めない形式
- 品質の問題:同じ顧客が複数のコードで登録されている、項目の使い方が部署によって異なる
AIへの影響:学習データや検索対象の形式・品質がばらばらなため、AIは「もっともらしい誤答」を返します。RAGで社内検索の仕組みを構築しても、古い情報や重複データを根拠に回答してしまいます。
データの問題は目に見えやすい一方、その背後には「データを外に出せない」という別の壁があります。
連携層:APIがなく、夜間バッチでしかデータが動かない
2つ目の壁は、データの「通り道」です。多くのレガシーシステムはモノリシック(一枚岩)な構造で、外部から呼び出せるAPIを持っていません。
- システム間連携はファイル転送や夜間バッチが中心
- 個別に作り込んだポイント・ツー・ポイント連携が網の目のように絡み合う
- 帳票出力が唯一のデータ出口というケースも珍しくない
AIへの影響:リアルタイムの予測や、問い合わせに即答するAIを作れません。AIエージェントに業務処理を任せることもできず、AIは「前日のデータを眺めるだけ」の存在にとどまります。
仮にデータを取り出せたとしても、まだ壁は残ります。そのデータが何を意味するのかわからないことが多いのです。
ロジック層:業務ルールがコードに埋もれ、AIが「意味」を理解できない
3つ目の壁は、データの「意味」です。レガシーシステムでは、業務ルールの多くがCOBOLやVBのプログラムの中に直接書き込まれています。
- 区分値「3」が何を意味するかは、プログラムの条件分岐を読まないとわからない
- 設計書が更新されておらず、仕様を知る担当者も退職している
- 例外処理が何十年分も積み重なり、全体像を誰も説明できない
AIへの影響:AIは数値を処理できても、業務上の意味までは理解できません。「売上」の定義が部署ごとに異なれば、AIの分析結果は経営判断に使えないものになります。この「ブラックボックス化」の全体像と自己診断の方法は、関連記事「ブラックボックス化の解説」で詳しく紹介しています。
最後に、データを「安全に使わせる」ための仕組みの問題があります。
ガバナンス層:権限・ログ・データの系譜が管理できない
4つ目の壁は、データの統制(ガバナンス)です。AIにデータを渡すには、「誰が・どのデータを・何のために使ったか」を説明できなければなりません。
- アクセス権限が画面単位でしか設定されておらず、データ項目ごとの制御ができない
- 利用ログが残らない、または追跡できない形式で残っている
- データがどこから来て、どう加工されたか(データリネージ)を追えない
AIへの影響:個人情報や機密情報が生成AIに流れ込むリスクを否定できず、法務・セキュリティ部門の承認が得られません。技術的には動作するAIが、統制の問題で本番運用に移行できないのです。
4つの層のまとめ
| 層 | 主な症状 | AI活用への影響 | 代表的な対処 |
|---|---|---|---|
| データ層 | サイロ化、独自形式、重複マスタ | 精度低下、RAGの誤答 | データ基盤・クレンジング |
| 連携層 | API不在、夜間バッチ依存 | リアルタイム活用・AIエージェント導入が困難 | API化、ラッパー方式 |
| ロジック層 | 業務ルールがコードに埋没 | 業務上の意味を反映できない分析 | リバースエンジニアリング、仕様復元 |
| ガバナンス層 | 権限・ログ・リネージ不在 | セキュリティ審査で停止 | 権限設計、監査ログ、データカタログ |
この4層をまとめて診断し、詰まっている層から順に解消していくのが、HBLABのシステムモダナイゼーション支援の基本的な考え方です。
【資料ダウンロード】レガシーの壁を、AIで越える — AI駆動型マイグレーションアセスメント ウェビナー資料
ソースコード解析・業務ロジック抽出・依存関係の可視化をAIでどう自動化するか、実際の事例とあわせて解説したウェビナーのスライドと録画を無料で公開しています。社内検討や稟議の参考資料にもご活用ください。
「つなぎ」の回避策がレガシーシステムの負債を増やす
4つの壁に直面した企業の多くは、まず手近な回避策でAI活用を始めようとします。短期的には有効に見えますが、実はそれぞれに隠れたコストがあります。
CSV手作業・Excel集計:鮮度と正確性の限界
最も手軽なのは、担当者がデータをCSVで抜き出し、Excelで整えてAIに渡す方法です。
- データは抽出した時点で古くなり、リアルタイム性は得られない
- 加工手順が担当者の頭の中にしかなく、新たな属人化を生む
- 手作業の転記ミスが、そのままAIの誤答につながる
手作業の限界を感じると、次に検討されるのが自動化です。
RPAによる画面連携:画面変更ひとつで止まる脆さ
RPAで画面を操作してデータを取得する方法は、APIがないシステムでもすぐに始められます。しかし、画面レイアウトや項目が少し変わるだけでロボットは停止します。データの取得経路そのものが脆いため、停止が許されない業務用AIの基盤には向きません。
もう一つ、組織的な回避策にも落とし穴があります。
部門ごとのAIツール導入:新たなサイロ化を生む
全社的な基盤整備を待たずに、各部門が個別にAIツールを導入するケースも増えています。その結果、部門ごとにデータのコピーが生まれ、AI導入がかえってサイロ化を深めるという逆効果が生じます。部門ごとにばらばらなAIツールが導入されることで全社的なサイロ化が進むリスクは、TechTargetジャパンの記事でも指摘されています。
こうした「つなぎ」は近道に見えて、実際には技術的負債を上乗せしているにすぎません。根本的な解決には、どの層に問題があるのかを正しく見極める必要があります。
自社のレガシーシステムはAI活用に耐えられるか?AIレディ診断チェックリスト
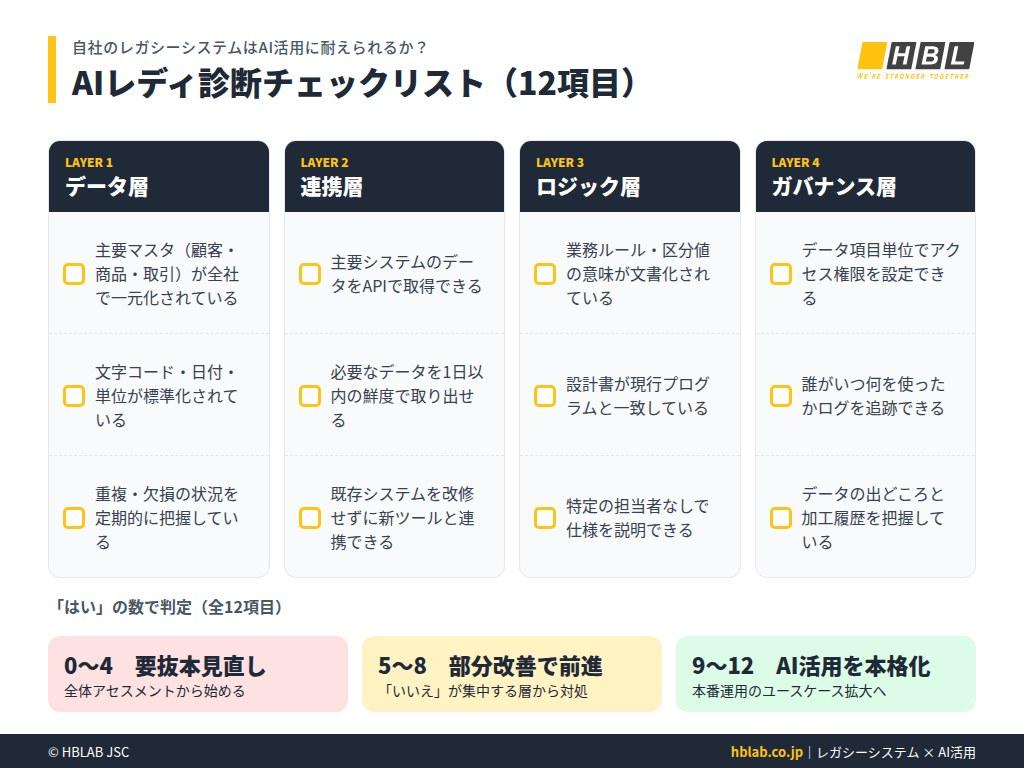
ここでは、自社システムのAIレディ度(AI活用への準備状況)を簡易的に確認できる12項目を紹介します。「はい」の数を数えてみてください。
データ層
- ☐ 主要な業務データ(顧客・商品・取引)のマスタが全社で一元化されている
- ☐ データの形式(文字コード・日付・単位)が標準化されている
- ☐ 重複や欠損の状況を定期的に把握している
連携層
- ☐ 主要システムのデータをAPIで取得できる
- ☐ 必要なデータを1日以内の鮮度で取り出せる
- ☐ 新しいツールとの連携を、既存システムを改修せずに追加できる
ロジック層
- ☐ 主要な業務ルール・区分値の意味が文書化されている
- ☐ 設計書が現行のプログラムと一致している
- ☐ 特定の担当者がいなくても仕様を説明できる
ガバナンス層
- ☐ データ項目単位でアクセス権限を設定できる
- ☐ 誰がいつどのデータを使ったかのログを追跡できる
- ☐ データの出どころと加工履歴(リネージ)を把握している
診断結果の目安
| 「はい」の数 | 判定 | 推奨アクション |
|---|---|---|
| 0〜4 | 抜本的な見直しが必要 | 複数の層が詰まっているため、全体のアセスメントから始める |
| 5〜8 | 部分改善で前進可能 | 「いいえ」が集中している層から優先的に対処する |
| 9〜12 | AI活用を本格化できる | 本番運用を前提としたユースケース拡大へ |
特定の層に「いいえ」が集中していれば、そこが最優先のボトルネックです。
【無料AI診断】チェック結果を、コードレベルの診断で裏付けませんか?
セルフチェックでわかるのは「傾向」までです。HBLABのAI診断では、移行難易度スコアやAIによる自動変換率の推定を含む詳細レポートで、どこから手を付けるべきかを具体的に示します(対応言語:Java、C#、VB、COBOL)。ソースコード(ZIP)をアップロードするだけで、24時間以内にレポートをメールでお届けします。無料・会員登録不要です。
ボトルネック別に選ぶ、AI活用に向けたレガシーシステム刷新アプローチ
レガシーシステムの刷新というと、全面的な作り直しを想像しがちです。しかし、AI活用が目的であれば、詰まっている層から順に手を打つほうが、コストもリスクも抑えられます。
連携層が課題なら:API化・ラッパー方式(全面刷新は不要)
データはあるのに取り出せない場合は、既存システムの外側にAPIの層(ラッパー)をかぶせる方法が有効です。基幹システム本体には手を入れずに、AIや新しいサービスからデータを呼び出せるようになります。最も短期間で効果を出しやすいアプローチです。
ただし、システム内のデータ自体の品質が低ければ、APIで取り出しても問題は解決しません。
データ層が課題なら:データ基盤・CDCで「AIが読めるデータ」をつくる
データの分散や品質が問題なら、業務システムとは別にデータ基盤を整備します。CDC(変更データキャプチャ)を使えば、基幹システムの更新をほぼリアルタイムで基盤に反映できます。基盤上でマスタ統合や形式の標準化を行い、AIが読める状態のデータを用意します。
一方で、データの「意味」がわからない状態では、基盤を作っても正しく統合できません。
ロジック層が課題なら:リバースエンジニアリングで仕様を再文書化
業務ルールがコードに埋もれている場合は、まず現行システムを解析して仕様を復元する必要があります。近年は、生成AIを使ってソースコードから設計書を自動生成する手法が、ソフトウェア開発におけるAI活用の一つとして実用段階に入っています(例:NTTデータの生成AIによる仕様復元の取り組み)。復元した仕様は、そのままAIに業務の文脈を与える「知識」としても活用できます。
複数の層が同時に詰まっている場合は、さらに計画的な進め方が必要です。
複数の層が重なるなら:ストラングラーパターンで段階的にモダナイゼーション
複数の層、あるいは4つの層すべてに課題がある場合は、システム全体のモダナイゼーションが視野に入ります。その場合も一括刷新ではなく、新しい仕組みで旧システムの機能を少しずつ置き換えるストラングラーパターンが現実的です。業務を止めずに、AI活用の効果が大きい領域から移行できます。
モダナイゼーションの全体像はSystem Modernization:レガシーシステムから発展の基盤へを、手法の選び方はモダナイゼーションとマイグレーションの違いをご参照ください。
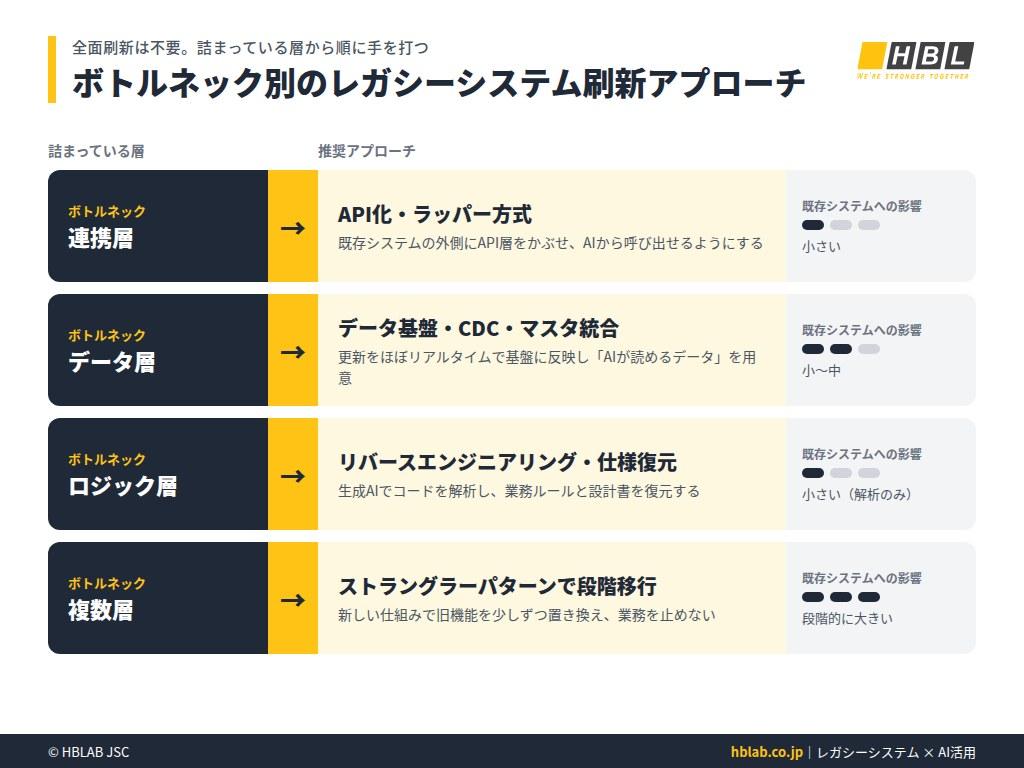
| ボトルネック | 推奨アプローチ | 既存システムへの影響 | 主なリスク |
|---|---|---|---|
| 連携層 | API化・ラッパー方式 | 小 | 中のデータ品質は改善されない |
| データ層 | データ基盤・CDC・マスタ統合 | 小〜中 | 意味の定義が曖昧だと統合が崩れる |
| ロジック層 | リバースエンジニアリング・仕様復元 | 小(解析のみ) | 解析範囲が膨らみやすい |
| 複数層 | ストラングラーパターンによる段階移行 | 大(段階的に発生) | 並行稼働期間の運用負荷 |
AIでAIの壁を崩す — 生成AIを活用したレガシーシステムの解析と移行
ここまで、レガシーシステムがAI活用を阻む構造を見てきました。しかし逆説的ですが、その壁を崩す最も有力な手段もまたAIです。
生成AIによるコード解析と仕様書の自動復元
かつてリバースエンジニアリングは、熟練エンジニアが何か月もかけてコードを読み解く作業でした。現在は生成AIがソースコードの構造や依存関係を解析し、設計書の下書きを作成できます。人はAIの出力を確認・補正する役割に集中できるため、解析のスピードと網羅性が大きく向上しています。
HBLABは、このAI活用を移行プロセス全体に組み込んでいます。
HBLABのAI駆動型モダナイゼーション:調査から結合テストまで
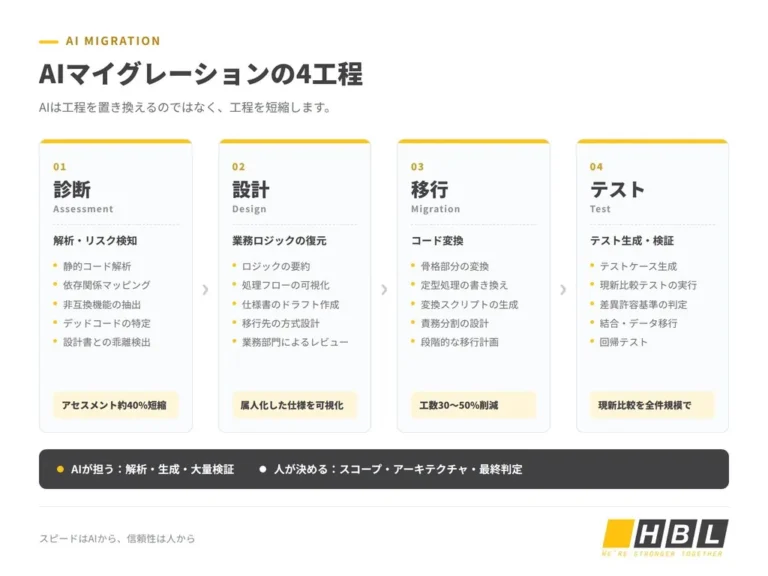
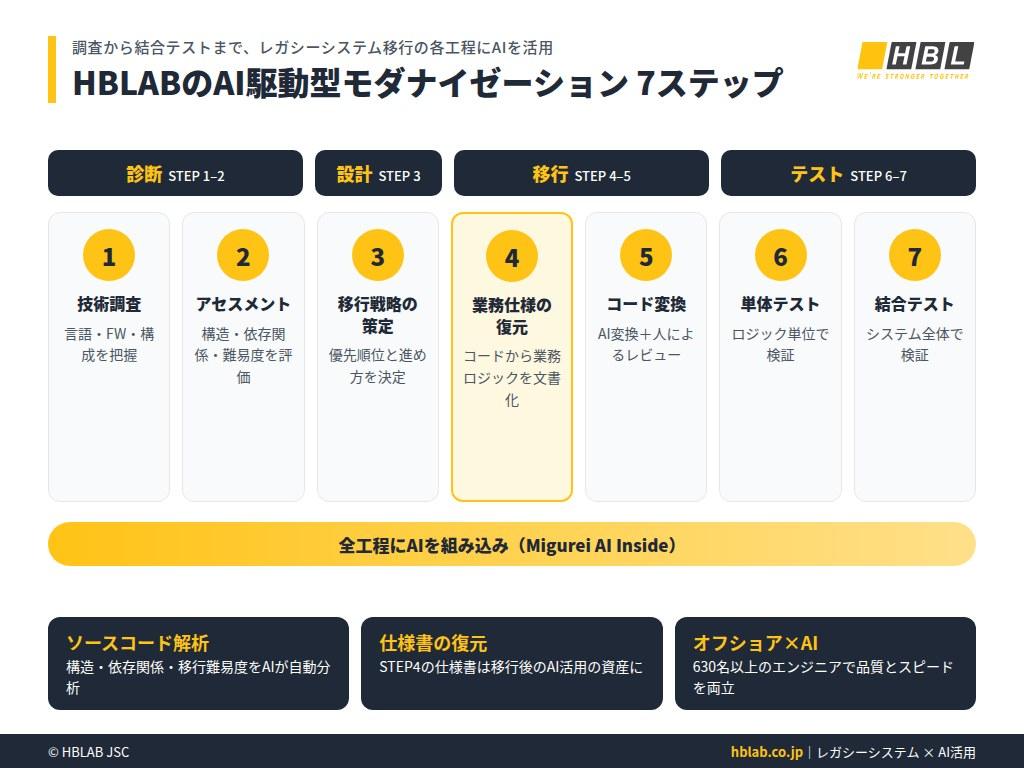
HBLABの「Modernization Solution(Migurei AI Inside)」は、診断・設計・移行・テストの各工程にAIを組み込んだ移行ソリューションです。具体的には、次の7ステップでレガシーシステムの刷新を進めます。
- 技術調査:現行システムの言語・フレームワーク・構成を把握
- アセスメント:構造・依存関係・移行難易度を評価
- 移行戦略の策定:優先順位と進め方を決定
- 業務仕様の復元:コードから業務ロジックを抽出し、ドキュメント化
- コード変換:AIによる変換と人によるレビューを組み合わせて実施
- 単体テスト:変換後のプログラムを機能単位で検証
- 結合テスト:モジュール間の連携と業務フロー全体を検証
ステップ4で復元された仕様書は、移行後のAI活用においても「業務の文脈」をAIに与える資産になります。対応実績のある移行パターンには、VB6/VBA→C#/Python、Java Struts→Spring Boot、COBOLのモダナイゼーションなどがあります。
630名以上のベトナム人エンジニアを擁するHBLABは、オフショア開発の体制とAIを組み合わせることで、移行の品質とスピードの両立を支援しています。委託先の選び方については、ベトナムのシステムモダナイゼーション開発会社5選も参考にしてください。
サービスの詳細はモダナイゼーションソリューション・マイグレーションサービスをご覧ください。移行の基本から知りたい方はマイグレーションとはも参考になります。
【事例資料・ご相談】大規模データの移行実績を確認する
HBLABが手がけたマイグレーション事例を、お客様の課題・解決策・成果とあわせてまとめた資料をご用意しています。自社のレガシーシステムに当てはめた進め方を相談したい方は、お気軽にお問い合わせください。
経営層をどう説得するか — レガシーシステム刷新を「AI投資の前提条件」として語る
レガシーシステムの問題を理解していても、刷新の予算を確保するのは簡単ではありません。特に情報システム部門の担当者にとって、稟議や社内説明の資料づくりは大きなハードルです。
「保守コスト削減」ではなく「AI投資の回収リスク」で語る
「保守費が高いので刷新したい」という説明は、経営層には「今は動いているのに、なぜ刷新が必要なのか」と受け取られがちです。
より伝わりやすいのは、「このままでは、すでに決定したAI投資を回収できない」という説明です。経営層がAI活用に期待しているのであれば、レガシーシステムの刷新は「コスト」ではなく、AI投資を成果につなげるための「前提条件」として位置づけられます。
では、その主張を裏付けるには、どんな数字を示せばよいのでしょうか。
稟議に載せたい3つのAI関連指標
経営層への説明では、AI活用に直結する次の3つの指標を示すと説得力が増します。
- データが原因で停止・延期したAI施策の数:PoC止まりになった案件と、その理由
- データ抽出・加工にかかる月間工数:CSV手作業やRPA保守に費やしている時間
- 新しいデータをAIで使えるようになるまでのリードタイム:依頼から利用開始までの日数
保守予算比率や変更リードタイムなど、刷新時期を判断する一般的な定量シグナルについては、関連記事の「刷新時期を示す4つの定量シグナル」で解説しています。社内資料の作成にあわせてご活用ください。
よくあるご質問
Q1. レガシーシステムのままでも生成AIは使えますか?
A. 文書作成や要約など、社内システムのデータを使わない用途であれば使えます。ただし、業務データを活用する用途(需要予測、社内データを使ったRAG、業務を自動処理するAIエージェントなど)では、本記事で紹介した4つの層の壁に直面します。
Q2. AI活用のために、システムの全面刷新は必要ですか?
A. 必須ではありません。連携層だけが課題ならAPI化、データ層ならデータ基盤の整備というように、ボトルネックとなっている層から対処するほうが、コストとリスクを抑えられます。
Q3. データ基盤(DWH)を作れば、レガシーシステムの問題は解決しますか?
A. データ活用の土台となるデータ層と連携層の課題は、大きな改善が期待できます。ただし、区分値の意味や業務ルールがわからないままでは、データを正しく統合できません。ロジック層の課題が残っている場合は、仕様の復元とあわせて進める必要があります。
Q4. RAGを導入するとき、レガシーシステムの何が問題になりますか?
A. 主に3点です。検索対象となるデータが古い・重複している(データ層)、最新データを随時取り込めない(連携層)、ユーザーごとに閲覧できる情報を制御できない(ガバナンス層)。これらが原因で、誤答や情報漏えいのリスクが生じます。
Q5. まず何から始めればよいですか?
A. 本記事のAIレディ診断チェックリストで、ボトルネックの層を把握することから始めましょう。より正確に把握したい場合は、ソースコードをもとにした無料のAI診断をご活用ください。
まとめ
レガシーシステムがAI活用の壁になる原因は、AIモデルではなく、データ層・連携層・ロジック層・ガバナンス層という4つの層にあります。PoCが成功しても本番で止まるのは、手作業で用意できたデータを、本番では継続的かつ安全に供給できないためです。CSV手作業やRPAといった「つなぎ」の回避策は、かえって負債を増やします。
まずはAIレディ診断で詰まっている層を特定し、API化・データ基盤の整備・仕様復元・段階的なモダナイゼーションの中から、その層に合った手法を選びましょう。全面刷新をしなくても、ボトルネックの層から順に手を打つことで、レガシーシステムを抱えたままでもAI活用を前に進められます。
あわせて読みたい
【HBLABについて】レガシーシステムの「AIの壁」を、AIで越える
株式会社エイチビーラボジャパン(HBLAB)は、10年以上の実績と630名以上のエンジニア体制を持つベトナムのIT企業です。ISO 27001・プライバシーマークを取得し、AIを組み込んだモダナイゼーション・マイグレーションで、日本企業のシステム刷新を支援しています。
- 👉 AI診断を無料で試す:ソースコードをアップロードするだけ。24時間以内にレポートをお届けします
- 👉 無料ウェビナー「MigrationはAIで加速。品質は、どう守る?」(2026年10月7日開催)に申し込む
- 👉 専門家に相談する(お問い合わせ)
自社のレガシーシステムでAI活用を進めるための最初の一歩として、お気軽にご相談ください。