マイグレーションのAI活用が特に効果を発揮するのは、現行資産の解析、業務ロジックの復元と仕様書の生成、そしてテストの生成・検証です。一方で、アーキテクチャの決定、業務ルールの妥当性判断、そして最終的な品質責任は、いまも人が担う領域です。
日本では2030年に約79万人のIT人材が不足するとされ、古い言語を読める技術者はさらに希少になると見込まれます。「AIにコードを読ませる」という選択肢が現実的になったのは、AIが完璧になったからではなく、読める人がいなくなりつつあるからです。
ただし、AIは自信を持って間違えます。請求額が数円ずれる程度の取り違えでも、基幹システムでは重大な事故につながります。本記事では、4工程でAIに任せられる範囲、工数削減が成立する前提条件、ハルシネーションの検知方法、そしてAIと人の責任分界を、実務目線で整理します。
マイグレーションのAI活用とは?——4工程で見る「できることの地図」
AIの話に入る前に、言葉を整理しておきます。マイグレーションとモダナイゼーションを混同したまま議論すると、「AIにどこまで任せられるか」の見積もりもずれてしまうからです。
マイグレーション・モダナイゼーション・リプレースの違い
この3つは同じ意味で使われがちですが、投資範囲もリスクの大きさも異なります。
| 用語 | 目的 | 変える対象 | 代表的な手法 |
|---|---|---|---|
| マイグレーション | 既存資産を活かしたまま新しい環境へ移す | 基盤・言語・インフラ | リホスト/リプラットフォーム/リライト |
| モダナイゼーション | システムを「発展し続けられる状態」にする | アーキテクチャと運用の両方 | マイグレーション+再構成+クラウドネイティブ化 |
| リプレース | 既存システムを廃止し、別の製品・SaaSへ移行する | システム全体と業務そのもの | パッケージ/SaaS導入 |
押さえておきたいのは、マイグレーションはモダナイゼーションの一部だという点です。マイグレーションはサポートが継続している環境へシステムを移すところまでを担い、その先の「移行後も発展できるか」に答えるのがモダナイゼーションです。
手法の選び方については、モダナイゼーションとマイグレーションの違いとマイグレーションの種類とメリットで詳しく解説しています。
用語が整理できたところで、本題である「AIマイグレーション」が具体的に何を指すのかを定義します。
AIマイグレーションとは何か(定義と4つの工程)
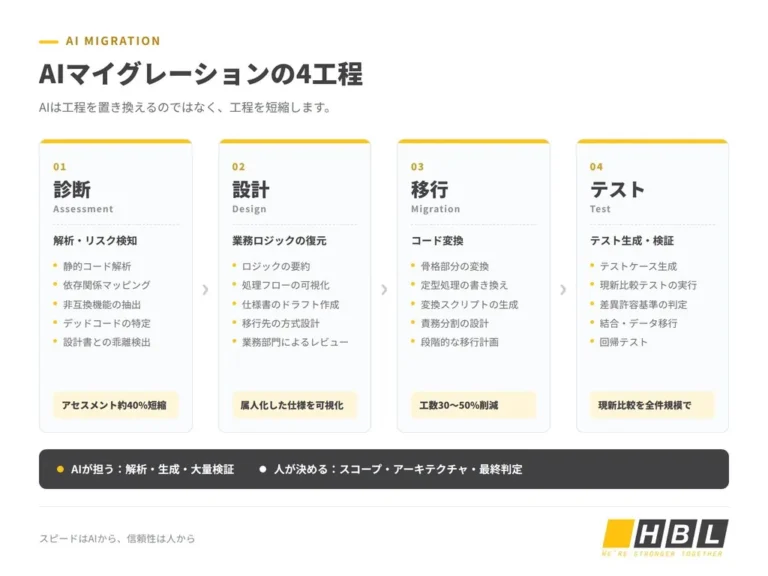
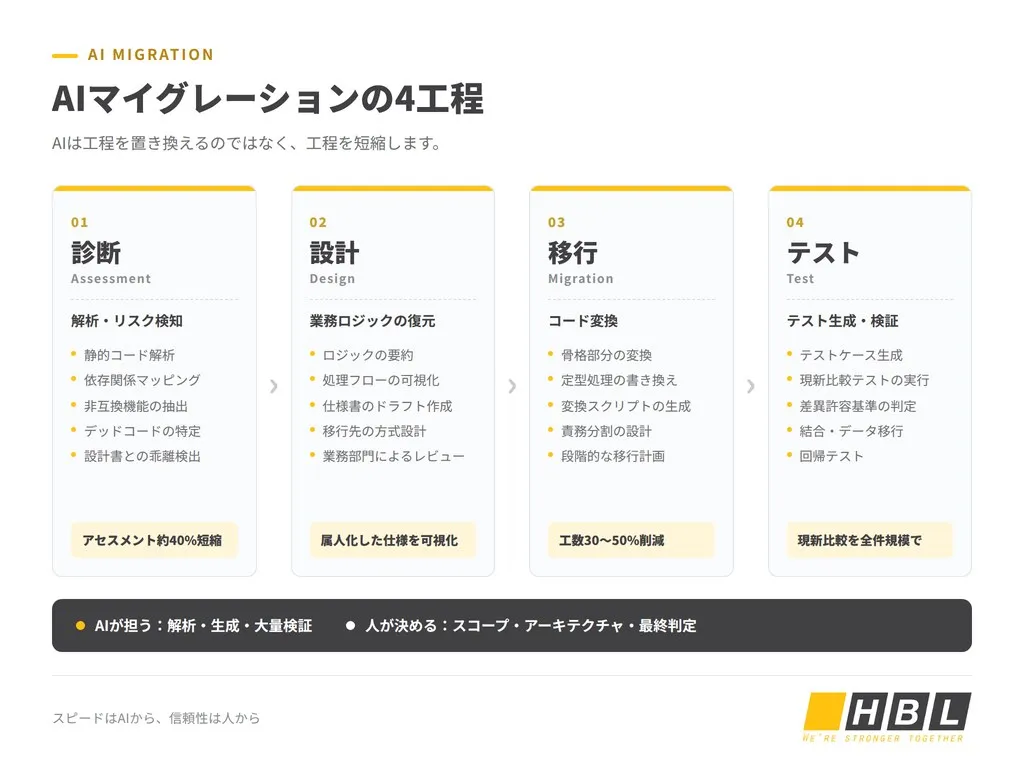
AIマイグレーションとは、既存システムの解析・仕様復元・コード変換・テスト検証という各工程に生成AIとAIツールを組み込み、人手による反復作業を削減しながらシステム移行を進める手法です。 AIが工程を置き換えるのではなく、工程を短縮するという点が本質です。
4つの工程は次のとおりです。
- 解析・リスク検知 — ソースを読み、依存関係を可視化し、非互換機能やデッドコードを洗い出す
- 業務ロジックの復元(仕様復元) — コードの中に埋もれた業務ロジックを読み解き、仕様として再構成する
- コード変換 — 骨格部分と定型処理を移行先の言語へ書き換える
- テスト生成・現新比較 — テストケースを生成し、旧システムと新システムの挙動を大規模に突き合わせる
この整理が重要なのは、期待値を左右するからです。AIを「コード翻訳機」と捉えると、③で失望しがちです。AIを「読解機であり検証機」と捉えると、最も価値を発揮するのは①②④だと分かります。
では、なぜこの数年で「AIを使う」という選択肢が現実味を帯びてきたのでしょうか。理由は技術の進歩だけではありません。
なぜ今「AI活用」が現実的な選択肢になったのか
3つの圧力が同時に高まっています。
第一に、サポート終了(EOL/EOS)の期日が具体化したこと。 多くの基幹システムでCOBOL資産を支えてきた富士通メインフレーム(GS21シリーズ)は、2030年度末に製造・販売を終了し、2035年度末に保守を終了する予定です。グループウェアとして広く使われてきたLotus Notes/Dominoも、IBM時代の旧バージョンは2024年6月に標準サポートが終了しました。サポート終了後はセキュリティ更新も不具合対応も受けられないため、判断を先送りできる時期はすでに過ぎています。
第二に、IT人材の不足と高齢化。 経済産業省の試算では、2030年に約79万人のIT人材が不足するとされ、とりわけ古いプログラミング言語を理解できる人材の減少が指摘されています。「保守できる人がいなくなる」というリスクが、現実のものになりつつあります。
第三に、放置した場合のコストが数値化されたこと。 経済産業省「DXレポート」は、既存システムの複雑化・老朽化・ブラックボックス化が解消されない場合、2025年以降に年間最大約12兆円の経済損失が生じる恐れがあると指摘しています。
この3つを重ねると、あまり正面から語られない事実が見えてきます。AIがマイグレーションに導入されるようになったのは、AIが十分に賢くなったからではなく、古いコードを読める人が消えつつあるからです。 だからこそ、「AIに書かせる」よりも「AIに読ませる」ほうが、確実に価値を生みます。
レガシーシステムが抱える構造的な問題については、「レガシーシステムが抱える5つの課題」もあわせてご覧ください。
工程別に見る:マイグレーションでAIが実際に効く4つの領域
下表が全体像です。注目していただきたいのは「期待できる効果」の列ではなく、最後の「成立の前提条件」の列です。同じ工程でも、前提が欠けていれば効果の数字は成立しません。
| 工程 | AIが担う作業 | 人が担う判断 | 期待できる効果 | 成立の前提条件 |
|---|---|---|---|---|
| ①解析・リスク検知 | 静的コード解析、依存関係マッピング、デッドコード/非互換機能の抽出 | 移行スコープの決定 | アセスメント期間を約40%短縮 | ソース一式が揃っていること |
| ②業務ロジックの復元 | ロジックの要約、処理フローの可視化 | 業務ルールの妥当性判断・承認 | 属人化した仕様の可視化 | 業務部門のレビュー体制があること |
| ③コード変換 | 骨格部分の変換、定型処理の書き換え | アーキテクチャ設計、責務分割 | 手作業比で工数30〜50%削減 | 変換ルールを事前に定義できること |
| ④テスト生成・検証 | テストケース生成、現新比較の大量実行 | テスト戦略の設計、差異の最終判定 | 現新比較を全件規模で実行可能 | 旧ロジックを「正解」として定義できること |
※工数30〜50%削減・アセスメント期間約40%短縮は当社実績に基づく参考値であり、対象言語・コード規模・要件により変動します。
4つの工程のうち、最も確実に効果が出るのは最初の「解析」です。人が最も時間を奪われる領域と、AIが最も得意な領域が、ここで重なっています。
①現行資産の解析とマイグレーションリスクの検知
この工程でAIが担うのは、反復的でありながら網羅性が求められる作業です。
- 静的コード解析によるモジュール単位の複雑度測定
- プログラム・バッチ・DB・API・外部連携の依存関係マッピング
- 移行先環境と非互換になる機能の抽出
- デッドコード・重複コードの特定
- 設計書と実コードの乖離の検出(長年の改修を経たシステムでは、ほぼ必ず存在します)
あまり語られない点を一つ挙げます。この工程の最大の価値は「速く移せること」ではなく、「移さなくてよい部分が分かること」です。 使われていないコードや廃止済み機能は、プロジェクト全体で見たときの最大のコスト削減余地になります。ただし、行数ベースで見積もるベンダーには、それを指摘する動機が働きにくいのが実情です。
また、発見が遅れると対応コストが極めて高くなるため、解析段階で早期に洗い出すべきリスクが2つあります。
- DB移行時の性能劣化 — 同じクエリでも、移行先DBでは実行計画がまったく異なる場合があります
- 文字コード変換 — EBCDIC → UTF-8 の変換では外字が化けやすく、本番データで初めて顕在化することが多くあります
「何があるか」が分かっても、「それが何をしているか」はまだ分かりません。次の壁が業務ロジックの復元です。
②業務ロジックの復元とAIリバースエンジニアリング
レガシーシステムには、すべてを左右する一つの特徴があります。「ソースコードが仕様書」であるということです。これ以上に信頼できる資料は存在しません。
一般的なコード補完ツールがレガシーシステムで的外れな提案をするのも、これが理由です。それらは「仕様をもとにコードを書く」流れを前提に学習されていますが、ここで必要なのは逆方向——コードを読んで仕様を再構築する作業だからです。
有効な進め方は、AIに「このシステムを理解して」と依頼することではありません。その依頼では、結果を検証できないからです。実務では次の順序で進めます。
- 検証可能な単位に分割する — 1バッチ、1帳票、1画面ずつ扱う
- 突き合わせ可能な形式で出力させる — 入力条件・分岐・期待結果の形にし、説明文にしない
- 実データで逆照合する — 本番データやログで再実行し、実際に出力された帳票と照合する
- 説明できなかった箇所を記録する — これが最も重要なリストです
4番目は省略されがちですが、「確信が持てない箇所」の一覧を伴わない復元仕様書は、かえってリスクになります。誤った安心感を生むからです。
復元したロジックは、担当者の頭の中にあるだけでは資産になりません。ドキュメントとして残せるかどうかが、次の分岐点です。
②-2 仕様書・設計書の自動生成
AIがコードから仕様書を生成する能力は、すでに一定の水準に達しています。ベンダーの差が出るのは「生成できるか」ではなく、誰が読むために生成するかです。
読み手は2種類おり、それぞれ必要とするものが異なります。
- 人は、承認と保守のために、業務的な文脈が分かるドキュメントを必要とします
- 後工程のAIは、機械可読な形式・統一された用語・要件〜コード〜テストのトレーサビリティを必要とします
HBLABは両方を満たす設計を採用しています。片方だけに向けたドキュメントは、短期間で価値を失うためです。
そのうえで、一つ率直にお伝えしておきます。誰もレビューしていないAI生成ドキュメントは、見た目が整っただけのブラックボックスです。 ドキュメントのように見え、ドキュメントとして保管されますが、中身に責任を持つ人がいません。だからこそ、承認者が署名する工程を必ず組み込みます。
ここまでの工程は「読む・書き出す」でした。多くの方が最初に期待する「AIによるコード変換」は、実は最も期待値の調整が必要な工程です。
③コード変換(AI-assisted Code Conversion):自動化はどこまで可能か
この領域については、現状を率直にお伝えします。以下の内容は、実際に取り組んだ技術者が公開している知見とも一致しており、判断材料として有効です。
最初に受け入れるべき3つの事実があります。
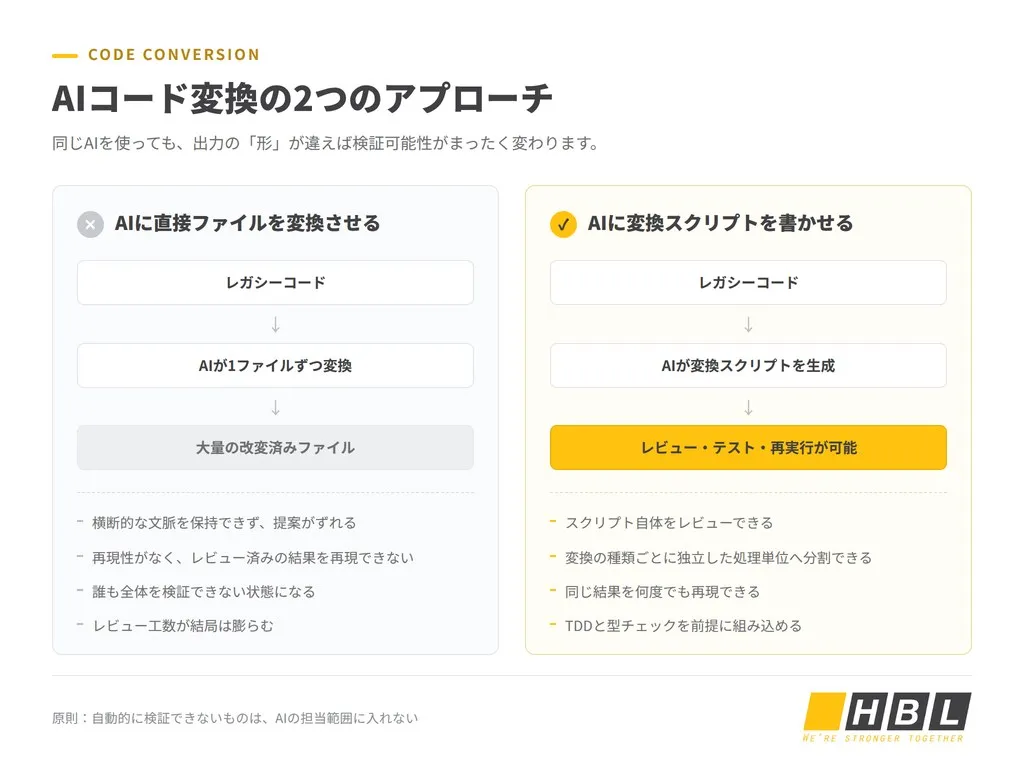
1. 大規模なソースコードを前提としたリファクタリングは、現在の生成AIが得意な領域ではありません。 コード補完ツールは1ファイル単位では有効ですが、数千モジュールを横断する文脈は保持できません。文脈がシステム全体に散在するレガシーシステムでは、提案がずれやすくなります。
2. 有効なのは、AIにファイルを直接変換させるのではなく、変換スクリプトを書かせる方法です。 違いは決定的です。この方法なら、AIの出力が、読んでレビューでき、テストや再実行も可能なスクリプトになるからです。誰も検証できない大量の改変済みファイルとは、扱いやすさがまったく異なります。スクリプトは、変換の種類ごとに独立した処理単位へ分割しておくと安定します。
3. 生成AIの出力には再現性が保証されません。 同じ指示でも実行のたびに結果が変わり得ます。ここから実務的な原則が導かれます。自動的に検証できないものは、AIの担当範囲に入れないということです。
実際の自動化の境界は次のとおりです。
| 自動化しやすい領域 | 人の判断が必要な領域 |
|---|---|
| 宣言部・型マッピング・構文変換などの骨格部分 | 業務ルールが絡む条件分岐 |
| パターンが反復する定型処理 | 業務上の例外処理のために規則を逸脱している箇所 |
| 仕様が明確な部分のテストコード生成 | アーキテクチャの再設計と責務分割 |
| 共通様式に沿った帳票・画面の変換 | 旧基盤固有の特性に依存する処理 |
「工数30〜50%削減」はどんな条件で成立するのか——LOCで見積もる
ベンダー間で工数削減率の数字だけを比べても、ほとんど意味がありません。同じ「50%削減」でも、達成できるかどうかはお客様のシステム側の前提条件に左右されるからです。
したがって、ベンダーに確認すべき問いは「何%削減できますか」ではなく、「当社のシステムでは、その数字はどの条件によって成立しますか」になります。
移行範囲をLOC(ソースコード行数)で定量化する
LOCは複雑度の指標として完璧ではありません。しかし、「複雑そうだ」という感覚にはない決定的な特性があります。測定でき、検証でき、発注側と受注側が同じ数字を見て合意できるという点です。
測定にあたっては、何を数えるかを事前に取り決めます。
- 実行行数 — 工数算出の主たる根拠
- コメント行 — 別勘定とする(コメントが多いと読解工数はむしろ下がる場合があるため)
- 重複コード — 同一ルールで変換できることが多く、工数は行数に比例しない
- デッドコード — 見積もり対象から明確に除外し、総数に含めない
LOCが確定して初めて、LOC → 人月 → 予算の順で算出できるようになります。そして稟議を通す立場の方にとってより重要なのは、予算に応じて移行範囲を分割し、優先順位をつけられることです。すべてを一度に実施する必要はありません。
これは「大きすぎて決裁できない案件」を、「決裁できる規模の案件の集合」に変えるための鍵でもあります。
削減率が伸びる条件/伸びにくい条件
下表はセルフチェック表としてお使いください。自社システムがどちらの列に多く当てはまるかで、期待値を調整していただけます。
| 削減率が伸びる条件 | 削減率が伸びにくい条件 |
|---|---|
| ソース一式と実行環境が揃っており、再現できる | ソースの一部が欠落している/本番稼働版と差異がある |
| 定型的な処理・画面が多く、パターンが反復する | 業務ルールと密に絡んだ分岐が中心を占める |
| 着手前に変換ルールを定義できる | 移行先アーキテクチャが未決定である |
| 旧システムの挙動を「正解」として使える(現新比較が可能) | 旧システムが停止済みで挙動を再現できない |
| 業務部門がレビューに参加できる | 仕様を承認できる有識者が不在である |
| デッドコード・未使用機能を対象外にできる | 全機能に「現行通り」の方針を適用する |
最後の行が最も注意を要します。一見「安全な方針」に見えて、実際には最もコストの高い選択になりやすいためです。
最大のコスト削減は「移行しないコードを決めること」
10年以上稼働してきたシステムには、すでに使われていないコードが相当な割合で含まれています。終了したキャンペーンのために作られた機能、誰も出力しなくなった帳票、統合済みの拠点向けの分岐処理などです。
それらを新システムへ運ぶことは、二重の支払いを意味します。移行する費用と、移行後も保守し続ける費用です。
問題は、行数ベースで見積もるベンダーには「30%は移行不要です」と伝える動機が働きにくいという点にあります。ここはお客様側から能動的に要求すべき項目です。
判断に使えるデータを、信頼度の高い順に挙げます。
- 利用実績ログ — どの機能が、直近いつ、実際に呼ばれているか
- 帳票の実出力頻度 — どの帳票が現在も印刷・送付されているか
- 業務部門へのヒアリング — 確認のために用い、決定の根拠にはしない(記憶はデータより保守的になりがちなため)
優先順位と全体スコープの決め方については、「レガシーモダナイゼーションの進め方」もご参照ください。
マイグレーションのAI活用の落とし穴:ハルシネーションはどこで起きるか
AIを使う前提でプロジェクトを組むなら、避けて通れない論点があります。それは「AIが自信を持って間違える」ことへの備えです。
立場を明確にしておきます。このリスクは実在しますが、プロセスの設計によって管理できます。以下はそのプロセスの説明であり、AIを使わない理由の説明ではありません。
マイグレーションで実際に起きる4つの典型パターン
1. ロジックの取り違え — 条件分岐の優先順位が入れ替わるパターンです。たとえば、旧システムでは「契約割引 → 数量割引」の順に適用していたものが、新システムでは逆になるといったケースです。結果として請求額が数円ずれます。実行時エラーも警告も出ず、エンドユーザーからの問い合わせで初めて発覚します。
2. 丸め誤差・日付境界 — 端数処理や境界条件が静かに変わるパターンです。四捨五入が切り捨てになる、31日ある月で月末締めが1日ずれる、といった形で現れます。一件あたりの差は小さくても、取引量に応じて累積します。
3. 文字コード・外字 — EBCDIC → UTF-8 変換で特定の外字が化けるパターンです。多くの場合、影響を受けるのは顧客の氏名です。つまり、業務部門が最初に目にするデータで問題が表面化します。
4. 再現性のなさ — 同じ指示でも実行のたびに出力が変わるパターンです。見た目以上に深刻で、レビュー済みの結果が再実行で再現しないことを意味します。出力を固定できなければ、「レビューした」という事実そのものが価値を失います。
工程別の検知ポイント:どこで止めるか
原則は一文で表せます。自動的に検証する手段がない作業は、AIの担当範囲に入れてはいけません。
この原則から、多くのプロジェクトが取り違えている順序が導かれます。テスト戦略は、変換に着手する前に設計しなければなりません。 テスト戦略こそが、AIに任せられる範囲を決めるからです。
| 工程 | 検知手段 | 判定する人 |
|---|---|---|
| 仕様復元 | 本番データ・ログ・帳票との突き合わせ | BA(ビジネスアナリスト)+業務部門 |
| ドキュメント生成 | ドキュメントとコードの相互レビュー、トレーサビリティ確認 | SA |
| コード変換 | 変換スクリプトのレビュー+モジュール単位の単体テスト | エンジニア |
| 挙動全体 | 同一入力データでの現新比較テスト | QA(品質保証担当)+BA |
| 金額系データ | レコード単位に加え、期間合計でも突合 | 業務部門 |
最終行は見落とされやすい項目です。丸め誤差はレコード単位の比較では現れず、期間合計で突き合わせて初めて顕在化します。
旧システムのバグは「そのまま移す」べきか
状況を理解した業務部門から、ほぼ必ず出る問いがあります。旧システムにバグがある場合、新システムはそのバグまで再現すべきか、修正すべきかという問いです。
選択肢は3つあり、それぞれ選ぶ条件が異なります。
| 選択肢 | 選ぶ条件 | 留意点 |
|---|---|---|
| バグも含めて現行通り移行 | 現在の業務がその挙動を前提に回っている場合(手作業での補正を含む) | 技術的負債を新システムへ持ち越す。「意図的な仕様」として明記が必須 |
| 移行時に修正する | バグが金額やコンプライアンスに影響する場合 | 現新比較で差異として検出される。想定差異として事前に申告しないと、テスト結果全体の信頼性が損なわれる |
| 現行通り移行し、別案件で修正 | 業務影響を期間内に確定できない場合 | 忘れられやすい。担当者を明示したバックログ化が必須 |
この問いについて最も重要な点は次のとおりです。これは業務部門が下すべき判断であり、技術部門の判断ではありません。ましてや、AIが判断することではありません。 AIが「正しく直してしまう」なら、それはハルシネーションの一種です。善意に見えるだけで、性質は変わりません。
品質を「数字」で担保する:旧ロジックを正解とする多層テスト
リスクを列挙するだけでは、稟議は通りません。数字で答えるべき問いは、どうやって品質を証明するのかです。
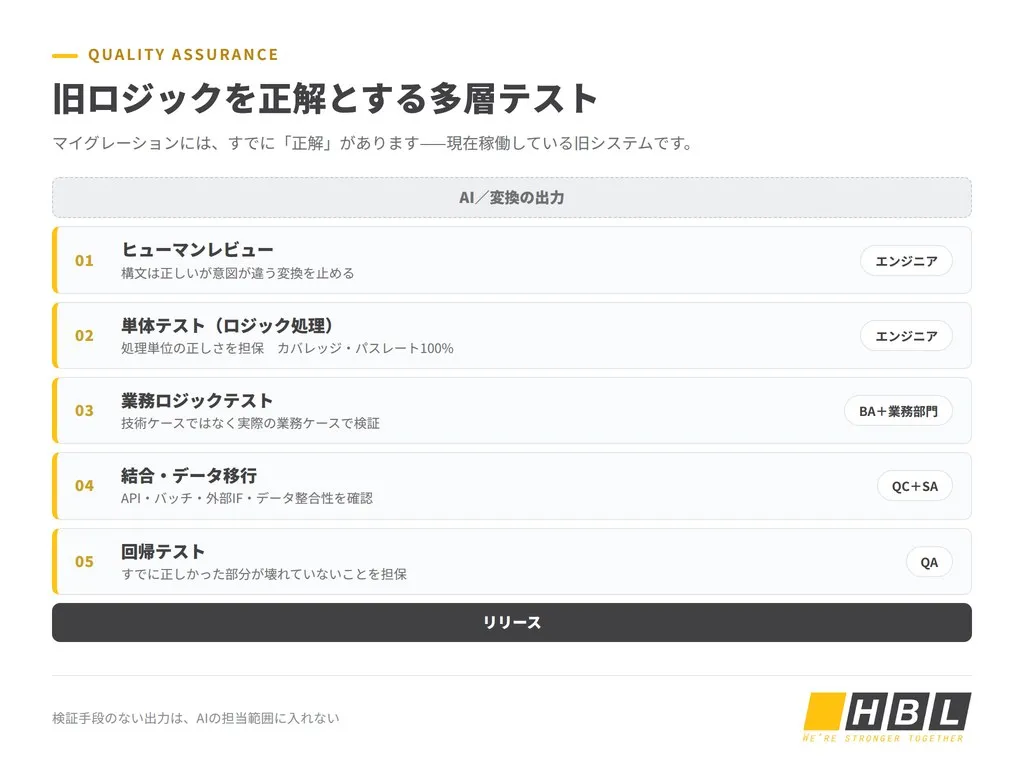
マイグレーションにおけるテスト戦略は、新規開発とは出発点が異なります。すでに「正解」が存在するからです——現在稼働している旧システムそのものが正解です。 これはマイグレーション案件だけが持つ最大の強みであり、同時に活用されないまま終わりがちな資産でもあります。
5つのテストレイヤー
AI/変換の出力
↓ ① ヒューマンレビュー
↓ ② 単体テスト(ロジック処理)
↓ ③ 業務ロジックテスト
↓ ④ 結合・データ移行テスト
↓ ⑤ 回帰テスト
リリース
- ヒューマンレビュー — テストでは捉えられない誤り、すなわち「構文は正しいが意図が異なる」変換を検出します。実施するのはエンジニアであり、AIではありません。
- 単体テスト(ロジック処理) — 処理単位の正しさを担保します。HBLABがロジック処理を対象にカバレッジ・テストパス率100%を担保するのは、このレイヤーです。
- 業務ロジックテスト — 技術的なケースではなく、実際の業務ケースで検証します。ケース設計はBAと業務部門が担当します。
- 結合・データ移行テスト — API・バッチ・外部インターフェースと、移行後データの整合性を確認します。
- 回帰テスト — その後の修正によって、すでに正しかった部分が壊れていないことを担保します。
カバレッジとテストパス率で「検収基準」を先に合意する
HBLABは、ロジック処理の単体テストにおいてカバレッジ・テストパス率100%を担保しています。
そのうえで、見落とされがちな点をお伝えします。この100%という数字は、「ロジック処理」の対象範囲を事前に定義して初めて意味を持ちます。 定義がなければ、100%は中身のない表現になり、検収の場で争点になります。
そこで、実務的なご提案です。HBLABを含むすべてのベンダーに対し、契約前に次の3点の明文化を求めてください。
- 対象範囲 — カバレッジの数字がどの部分に適用され、何を除外するのか(UI、外部連携、自動生成コードなど)
- 測定方法 — どのツールを使い、行単位・分岐単位のどちらで測定するのか(line coverage か branch coverage か)
- 差異が出たときの扱い — 誰が、どの期間内に判定し、修正費用はどちらが負担するのか
この3つの問いは、どんな提案書よりも早くベンダーを見極める手がかりになります。
現新比較テストの「差異許容基準」をどう決めるか
現新比較テストは、マイグレーションにおける品質保証の根幹です。しかし実行段階では、営業資料では触れられない3つの問いに突き当たります。
全件実行か、サンプリングか。 原則として、金額とコンプライアンスに関わるデータは全件実行します。それ以外は、取引種別・期間・拠点などによる層化サンプリングとし、無作為抽出は避けます。不具合は境界ケースに集中しやすく、境界ケースは希少だからです。
どの差異を許容するか。 テスト開始前に許容差異の一覧を宣言します。たとえば、事前に定めた閾値未満の丸め誤差、日付フォーマットの違い、文字コード変換後の表現差などです。一覧にない差異は、原則としてすべて不具合として扱います。「要判断」という保留枠を作らないことが肝心です。
本番データを使う場合、個人情報をどう扱うか。 テスト環境へ投入する前にマスキングが必要ですが、そのマスキングはデータの分布特性を保持しなければなりません。マスキングによって境界ケースが失われれば、テスト自体が無意味になります。この論点は、後述するセキュリティの確認項目に直結します。
AIと人間の責任分界:AIに任せる作業と、人が決める判断
テストの話をすると、議論は多くの場合、同じ問いに行き着きます。最終的に、誰が責任を持つのかという問いです。
工程別 責任分界表
| 作業・判断 | AI主体 | AI+人レビュー | 人のみ |
|---|---|---|---|
| 静的コード解析・依存関係の抽出 | ● | ||
| 業務ロジックの要約・可視化 | ● | ||
| 仕様書のドラフト作成 | ● | ||
| 骨格・定型処理のコード変換 | ● | ||
| テストケースの大量生成 | ● | ||
| 現新比較の実行 | ● | ||
| 移行スコープ・優先順位の決定 | ● | ||
| アーキテクチャ設計・責務分割 | ● | ||
| 業務ルールの妥当性判断 | ● | ||
| 差異の最終判定(許容か不具合か) | ● | ||
| 廃止する機能の決定 | ● | ||
| 性能SLA・検収基準の合意 | ● |
表を縦に読むと、一つの法則が見えてきます。AIが担うのは「実行」、人が担うのは「決定」です。そして「人のみ」の欄に並ぶ項目には共通点があります。いずれも、間違えたときに誰かが責任を負わなければならない種類の判断です。
有識者が不在のとき、復元した仕様は誰が承認するのか
レガシー移行において最も難しく、そしてほとんど答えが示されていない問いがあります。システムを作った人はすでに退職している。では、AIが復元した仕様書に誰が署名するのか。
承認できる人が見つかるまで待つことはできません。実務では次の4ステップで進めます。
1. 記憶ではなく、データから逆にたどる。 本番データ、ログ、出力済みの帳票は、システムの実際の挙動を示す証拠です。人の記憶と異なり、これらは時間がたっても失われません。
2. 仕様を「検証可能な形」に変換する。 「優先顧客区分の場合は特別割引を適用する」という説明文ではなく、「この入力 → この期待結果」という具体的なケースに落とし込みます。業務部門は説明文を判定できませんが、具体的なケースなら判定できます。
3. そのケースを軸にヒアリングを設計する。 具体的なケースを20件提示し、「正しい/違う/分からない」で答えてもらうほうが、200ページの資料を読んでもらうより確実です。
4. 承認記録を残す。 誰が、どのケースを、いつ承認したか。「分からない」と回答された部分も、担当者付きのリスクとして記録し、空欄のままにはしません。
マイグレーション案件にエンジニアに加えてBAとSAが必要なのは、ここに理由があります。彼らの役割はドキュメントを書くことではなく、答えられない問い(「このシステムは何をしているのか」)を、業務部門が答えられる問いへ変換することです。
人がAIに勝てる領域は「責任を引き受けられること」
結論から申し上げます。人がAIに勝てるのは、一つの判断に責任を引き受けられること、そして誰も書き残していない文脈を理解できることです。
AIは網羅性と速度に優れ、疲れることもないため、50万行のコードを眠気で読み飛ばすことはありません。人は文脈の理解、トレードオフの判断、そして結果に対する責任において強みを持ちます。
マイグレーションでは、この分担がとりわけ明確に現れます。AIは「このコードが何をしているか」に答えられます。しかし「この業務はどうあるべきか」に答えられるのは人だけです。
これがHBLABの進め方の根底にある考え方です。スピードはAIが担い、信頼性は人が確保する。
移行後に「ブラックボックス」を再発させないための設計
あまり意識されない事実があります。マイグレーションが完了した瞬間は、次のブラックボックスの始まりにもなり得るということです。
システムも言語も新しくなった。しかしドキュメントが再びコードと乖離し、知識が再び数名の頭の中にとどまるなら、5年後の状況は今日とほとんど変わりません。違うのは言語の名前だけです。
そして、再発防止策を講じられるのは、移行プロジェクトの期間中だけです。プロジェクト終了後に、ドキュメント整備のための予算が下りることはほとんどありません。
「AIフレンドリードキュメント」とは何か
HBLABは30種類以上のドキュメントを整備し、納品しています。これらは人とAIの双方が扱えるように設計しています。「AIフレンドリー」を成立させる要件は次の3点です。
- 機械可読な形式 — Word文書に貼られた表の画像ではなく、機械が解釈できる形式であること
- 統一された用語 — 一つの業務概念に対し、全ドキュメントを通じて呼称が一つであること
- 要件〜コード〜テストのトレーサビリティ — 変更の影響範囲を追跡できること
読み手による分類は次のとおりです。
| 分類 | 主な読み手 | 更新タイミング |
|---|---|---|
| 業務ドキュメント(業務フロー、業務ルール、帳票) | 業務部門 | 業務が変わったとき |
| 設計ドキュメント(アーキテクチャ、DB、インターフェース、バッチ) | 保守ベンダー、SA | 設計変更時 |
| トレーサビリティ資料(要件〜コード〜テストのマトリクス) | QA、エンジニア | リリースごと |
| AI向け資産(データディクショナリ、規約、ADR=アーキテクチャ決定記録) | 後工程のAIエージェント、新規参画エンジニア | 新たな決定があったとき |
最後の分類(AI向け資産)はまだほとんど注目されていませんが、その後システムをAIで発展させられるかどうかを左右する層です。
移行を「ゴール」ではなく「入口」にする
移行の過程で整備したドキュメントと資産は、新システムの稼働開始とともに役目を終えるわけではありません。次の3つの取り組みの基盤になります。
- 次のモダナイゼーション — 部分的な再構成、段階的なクラウドネイティブ化
- AI駆動開発 — AIは新任エンジニアと同じく、良質なドキュメントがあって初めて力を発揮します
- データ活用 — データは、データディクショナリと業務定義が揃って初めて使えるようになります
HBLABがマイグレーションを「入口」と位置づけ、AI native scale builder——AIを核として、移行後も伴走するパートナー——を目指しているのはこのためです。この考え方は、10年以上の事業を通じて一貫して大切にしてきた「Data & AI first」と「継続的なカイゼン」に基づいています。
サービスの詳細はHBLAB Modernization Solution(Migurei AI Inside)をご覧ください。
内製化とスキルトランスファー:新しいロックインを作らない
一見すると合理的なモデルがあります。診断から移行、そして24時間365日の運用保守までを同一チームが担当するというものです。引き継ぎがないため、引き継ぎに伴う品質低下も起きません。
しかし、その裏側も直視しておく必要があります。それは、メインフレームのロックインを、新しいベンダーロックインに置き換えているだけかもしれません。サポートの切れた基盤からは脱出できても、自社だけでは運用できない依存関係に陥ることになります。
お客様が実際に新システムを自社で保守できる状態に到達するための条件は、次の3つです。
- プロジェクト外の人が読んで理解できるドキュメント — プロジェクトに参加していないエンジニアに読ませ、内容を説明させることで検証できます
- 再現可能なビルド環境 — ドキュメントだけでゼロから構築でき、当時の担当者に問い合わせる必要がないこと
- 計画されたナレッジトランスファー — 引き継ぎ会議1回ではなく、スケジュール・受け手・理解度を確認する演習がセットになっていること
そのうえで、HBLABを含むあらゆるベンダーに確認していただきたい3つの問いをご紹介します。
- 移行後の保守は、自社でできる状態になるのか
- そのために、何が納品されるのか
- ならない場合、その理由は何か
3つ目が最も重要です。誠実なベンダーであれば、この問いに具体的な答えを持っているはずです。
ソースコードをLLM(大規模言語モデル)に渡す前に確認する6項目
この6項目は、提案の場で話題に上らなかったとしても、社内の稟議ではほぼ確実に問われます。あらかじめ答えを用意しておくことで、情報セキュリティ部門でプロジェクトが止まる事態を避けられます。
- 学習への利用 — データが学習に使われないか。学習に利用されない設定であること(必要に応じて、データを保持しないゼロデータリテンションの設定であること)を、口頭ではなく書面で確認します。
- 保管リージョンとログ保持期間 — データがどの地域に保管され、ログが何日保持され、誰がログにアクセスできるか。
- 生成コードの権利帰属 — AIが生成したコードの著作権・知的財産権が誰に帰属するか。既定に委ねず、契約条項に明記します。
- OSSライセンスの混入リスク — AIが制限の強いライセンスを持つOSSと同一のコードを出力する恐れがあります。ライセンススキャンのツールと、検出時の対応手順を用意します。
- 本番データのマスキング方針 — テストに本番データを用いる場合、マスキングは分布特性を保持する必要があります(前述の現新比較テストと直結します)。
- 業界規制への対応と第三者認証 — 金融・公共分野では、業界基準との照合とベンダーの認証状況の確認が必要です。
6番目について、HBLABはプライバシーマーク(Pマーク)、ISMS(ISO/IEC 27001)、CMMIレベル3を取得しています。実績の誇示としてではなく、上記の確認項目に対する回答の裏づけとしてご参照ください。
マイグレーションのAI活用が失敗する5つの理由
この分野の情報の多くは成功事例で構成されています。しかし意思決定者にとっては、失敗のパターンのほうが学びが大きいはずです。以下の5つは、実際に取り組んだ技術者が公開している記録に基づくものです。
1. 技術の壁——AIにシステム全体を読ませようとする 症状: AIの提案が的外れになり、現場が「自分で書いたほうが100倍早い」と結論づける。 原因: AIは数千モジュールを横断する文脈を保持できない。 回避策: 検証可能な単位(1バッチ、1帳票、1画面)に分割する。
2. 人・組織の壁——現場に「今それをやる意味」が共有されない 症状: 実行チームやパートナーに試行の動機が生まれず、AI活用が追加の負担として受け止められる。 原因: 効果がプロジェクト全体の数字で語られ、各自の担当範囲では実感できない。 回避策: 効果測定の単位を工程ごとに区切り、各チームが自分たちの数字を見られるようにする。
3. 修正と破壊の無限ループ——仕様が不足したまま生成を繰り返す 症状: 一箇所を直すと別の箇所が壊れ、収束しない。 原因: AIが仕様の空白を推測で埋め、推測の内容が毎回変わる。 回避策: 「仕様の確定」を、期間と責任者を持つ一つの工程として認める。
4. テスト工程の軽視——変換が終わってからテストを考える 症状: AIの出力を評価する基準が存在しない。 原因: 順序が逆になっている。本来はテスト戦略こそがAIに任せられる範囲を決める。 回避策: 変換着手前にテスト戦略を設計する。
5. 属人化の再生産——AIの使い方自体が特定の人に依存する 症状: チーム内で「聞き方を知っている人」が一人だけで、その人が抜けると生産性が元に戻る。 原因: プロンプトも手順も判定基準も、暗黙知のままになっている。 回避策: プロンプト・手順・判断基準を成果物として扱い、個人のコツにしない。
5つ目は最も皮肉で、最も語られることの少ないパターンです。属人化を解消するためにAIを導入したのに、新たな属人化を生んでしまうというものです。対処しなければ、企業はブラックボックスの種類を入れ替えただけになります。
HBLABのアプローチ:Migurei AI Inside と無料AIアセスメント
ここまでは、ベンダーを選ぶ前に知っておくべき内容でした。ここからは、それぞれの論点にHBLABがどう応えるかをご説明します。
診断 → 設計 → 移行 → テストの4モジュール
「HBLAB Modernization Solution」は、独自のAIツールセット「Migurei AI Inside」を中核に、移行の全工程を4つのモジュールでカバーします。これは本記事で整理した4工程にそのまま対応しています。
| モジュール | 対応する工程 | 本記事のどの論点に応えるか |
|---|---|---|
| 診断(Assessment) | ①解析・リスク検知 | LOC・スコープ・リスクの可視化 |
| 設計(Design) | ②業務ロジックの復元+移行先設計 | 有識者不在時の仕様承認プロセス |
| 移行(Migration) | ③コード変換 | 自動化の範囲と限界 |
| テスト(Test) | ④テスト生成・現新比較 | 品質を数字で証明する方法 |
本ソリューションには、これまでに手がけた500件以上のマイグレーション・AIプロジェクトで培った経験とノウハウを活かしています。COBOLなどの旧世代の言語で構築されたシステムから、サポートが終了したバージョンの言語・フレームワークで構築されたシステムまで、幅広く対応します。
対応する主な移行パターン
- VB6 / VBA → C# / Python
- Java Struts → Spring Boot
- COBOL → Java など
- Lotus Notes → Intramart
- ネイティブ(iOS/Android)→ Flutter
※上記は当社が特に強みを持つ主要な5つの移行パターンです。これら以外の言語・システムについても、お客様のご要望に応じて柔軟に対応いたします。
オフショア体制の活用をご検討の場合は、ベトナムのモダナイゼーション開発会社の選び方もあわせてご覧ください。
スモールスタート:無料AI診断 → 小規模PoC → 段階的な本格移行
最初から全体をご契約いただく必要はありません。3つのステップは、それぞれが「次に進むかどうか」を判断できる区切りになっています。
| ステップ | 内容 | お客様にご用意いただくもの | 得られる成果 |
|---|---|---|---|
| 1. 無料AI診断 | コード構造・依存関係・難易度の分析、移行リスクの評価 | 対象ソース一式(NDA締結のうえ) | 診断レポート(LOC・リスク・推奨スコープ) |
| 2. 小規模PoC | 限定した範囲で実現可能性と効果を検証 | PoC範囲の選定(HBLABと共同) | 稟議に使える定量的な検証結果 |
| 3. 段階的な本格移行 | 予算と優先順位に応じて範囲を拡大 | — | 新システム+30種類以上のドキュメント |
この3ステップの構成は、契約面の課題への回答でもあります。実際の規模が判明する前に全体を確約するのではなく、段階的に契約するという進め方です。
参考資料:Modernization Solution(Migurei AI Inside)のリリース情報
期間限定・先着10社限定:無料AI診断
内容: コード構造・依存関係・難易度の分析、移行リスクの評価
対象: VB6/Java Struts/ネイティブ/COBOL/Lotus Notes、または旧バージョンの言語・フレームワークをご利用の企業さま
費用: 無料
よくある質問(FAQ)
Q1. AIマイグレーションとは何ですか?
AIマイグレーションは、既存システムの解析・仕様復元・コード変換・テスト検証の各工程に生成AIとAIツールを組み込み、人手の反復作業を削減しながらシステム移行を進める手法です。AIが工程を置き換えるのではなく、工程を短縮します。最も確実に効果が出るのは、解析と仕様復元の工程です。
Q2. 生成AIだけでマイグレーションは完結しますか?
完結しません。少なくとも3つの判断は人が担う必要があります。移行スコープの決定・アーキテクチャ設計・現新差異の最終判定です。いずれも「間違えたときに責任を負う」判断であり、AIは責任を負えません。
Q3. 人間がAIに勝てる領域はどこですか?
一つの判断に責任を引き受けられること、そして誰も書き残していない文脈を理解できることです。AIは網羅性と速度に優れ、疲れることもありません。一方、人は文脈理解・トレードオフの判断・結果への責任に強みを持ちます。マイグレーションでは、AIは「このコードが何をしているか」に答えられますが、「この業務はどうあるべきか」に答えられるのは人だけです。
Q4. マイグレーションのAI活用で、工数削減率はどのくらい期待できますか?
反復作業(読解・文書化・骨格部分の変換)の自動化により、手作業比で工数30〜50%削減、アセスメントと文書化の期間で約40%短縮が目安です(当社実績に基づく参考値であり、対象言語・コード規模・要件により変動します)。ただしこの数字には前提条件があります。ソース一式が揃っているか、旧システムの挙動を「正解」として使えるかによって大きく変わるため、本文の「削減率が伸びる条件/伸びにくい条件」の表をご確認ください。
Q5. AIが生成したコードの品質はどう保証しますか?
旧ロジックを「正解」とする多層テストで検証します。ヒューマンレビュー → 単体テスト → 業務ロジックテスト → 結合・データ移行テスト → 回帰テストの5レイヤー構成です。ロジック処理の単体テストではカバレッジ・テストパス率100%を担保します。なお、この100%が意味を持つのは「ロジック処理」の対象範囲を事前に定義した場合だけですので、契約前に対象範囲・測定方法・差異が出たときの扱いの3点を必ず定義します。
Q6. ソースコードをAIに渡してもセキュリティ上問題ありませんか?
6つの確認項目を満たせば、リスクを管理できます。学習への利用(学習に利用されない設定・ゼロデータリテンション)・保管リージョンとログ保持期間・生成コードの権利帰属・OSSライセンス混入リスク・本番データのマスキング方針・業界規制への対応の6点です。HBLABはプライバシーマーク、ISMS(ISO/IEC 27001)、CMMIレベル3を取得しています。
Q7. どの規模から相談できますか?費用の目安は?
規模の下限はありません。費用はLOC(ソースコード行数)ベースで定量化するため、測定可能な根拠に基づいて見通せます。まず無料AI診断でLOCと移行リスクを可視化し、そのうえで予算に応じて範囲を分割し、優先順位をつけられます。最初から全体をご契約いただく必要はありません。
まとめ
ここまで、4つの工程でAIに任せられる範囲、工数削減が成立する前提条件、ハルシネーションの典型パターンと工程別の検知方法、旧ロジックを正解とする多層テスト、そしてAIと人の責任分界を見てきました。
整理すると、AIが確実に効くのは「読む・書き出す・大量に検証する」領域です。一方で、移行スコープ、アーキテクチャ、業務ルールの妥当性、そして差異の最終判定は、人が決める領域のままです。そして、移行後のブラックボックス化を防げるかどうかは、移行プロジェクトの中でドキュメントをどう残したかで決まります。
レガシー移行を「一度きりの工事」で終わらせないために、マイグレーションのAI活用は、速度に加えて、移行後に残る資産の質でも評価する必要があります。まずは無料AI診断で、自社システムの現状を数字で確認してみてください。
無料AI診断で、自社システムの現状を数字で確認する
HBLAB Japan — 500件以上のプロジェクト実績 | 日本市場での10年 | プライバシーマーク・ISMS(ISO/IEC 27001)・CMMIレベル3