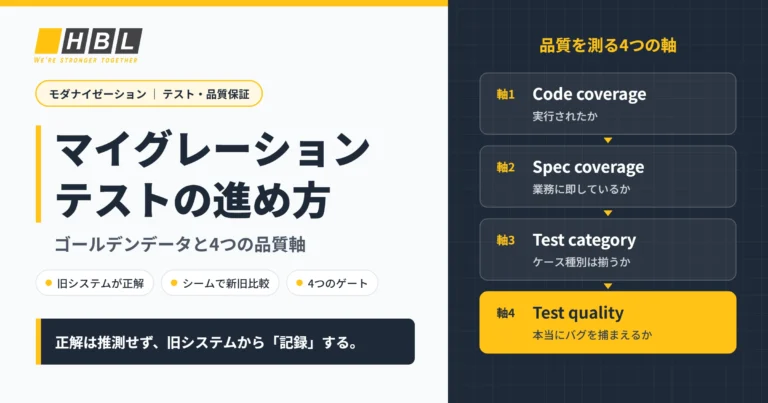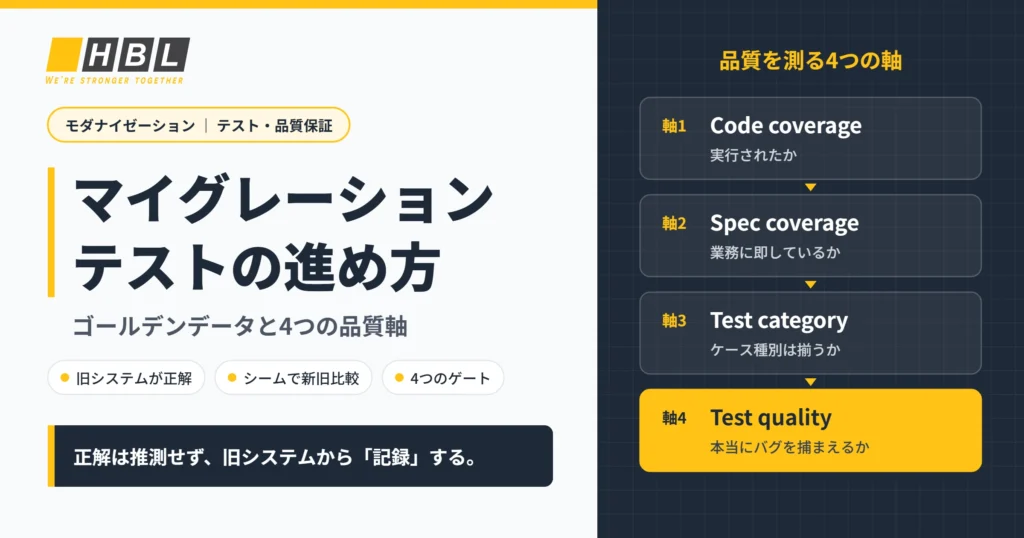
マイグレーションテストとは、既存システムを新しい環境・構造へ移行する際に、移行後のシステムが移行前と同じ業務結果を出すことを検証するテストです。リファクタリング型のマイグレーションテストでは、失われた仕様書ではなく旧システムそのものが正解になります。旧システムの出力を「ゴールデンデータ」として記録し、新旧で消えない接合点(シーム)で比較する。そして品質はコードカバレッジひとつではなく、Code・Spec・Test category・Test qualityの4つの軸で、リファクタリングを始める前に測ります。
本記事では、HBLABが実際のマイグレーション案件で使っているマイグレーションテストの進め方を、テストの置き場所、ゴールデンデータの作り方と網羅性評価、AIの役割、差異の分類まで順に解説します。
リファクタリング案件では、仕様書は多くの場合失われているか、いま動いている実態と合わなくなっています。信頼できる唯一の正解は旧システムそのものです。正解の出どころが変わる以上、テストスイートの品質の測り方も変えなければなりません。さらに、コードカバレッジでは最も重要な問いに答えられなくなります。
テーマ:レガシーマイグレーション · リファクタリング | 対象読者:PM、BrSE、QCリード | 連載:第1回/全2回
サンプル入力 ──▶ 新システム ──▶ 出力 → 正解と比較
リファクタリングのテスト戦略は、すべてこの2行に収まります。難しいのは比較そのものではなく、その背後にある3つの問いです。どの入力を選ぶか、比較ポイントをどこに置くか、そしてその入力セットで十分だとどう判断するか。
01 マイグレーションテストの正解はどこから来るのか
どんなテストにも、結果を突き合わせる対象が必要です。新規開発であれば、それは仕様書です。明確で、手元にあり、顧客の承認も済んでいます。ところがマイグレーション案件では、仕様書は多くの場合失われているか、残っていても10年にわたる改修を経た現行システムとはもう一致していません。
リファクタリングでは、この問いに明確な答えがあります。正解を旧システムそのものから得るのです。旧システムに入力を与えて実行し、出力を記録し、それを基準とみなします。テストはドキュメントからではなく、旧コードから生まれます。
このアプローチには耳の痛い帰結がひとつあり、最初の打ち合わせの時点で顧客に伝えておくことが望ましいでしょう。10年間残り続け、業務側がすでに適応しているバグ——それを回避する手作業の手順があり、それを前提に算出されているレポートがある——は、リファクタリングにおいては仕様です。意図的にそのまま残します。直したいのであれば別リリースで行い、マイグレーションには混ぜません。
顧客から最も多く寄せられる質問は、実は的外れ
「カバレッジは何パーセントですか?」——テスト品質について、ほぼすべての顧客が最初に尋ねる質問です。リファクタリング案件において、これは的外れな質問です。まもなく削除されるコードでカバレッジ95%を達成しても、新システムが正しく動くかどうかについては何も示しません。さらに悪いことに、その数字を追いかけるとチームは誤った方向へ進みます。その理由は03章で説明します。
本稿では、実際のプロジェクトが解決しなければならない順番に沿って、4つの問いに答えます。
- コード構造がまもなく消えるとき、テストはどこに置くべきか?
- 何千ものケースの正解を、一件ずつ手書きせずにどう用意するか?
- そのデータセットで十分に網羅できているかを、どう判断するか?
- コードカバレッジでないなら、「十分」を何で測るのか?
リファクタリングは、コードの変更を伴うマイグレーションの方式のうちのひとつです。もうひとつの方式——リビルド、つまりゼロから書き直し、顧客が確認した新しいドキュメントから正解を得る方式——では、本稿の内容のほぼすべてが逆転します。それは第2回で扱います。
02 リファクタリングを選ぶべきとき、選ぶべきでないとき
本稿の手法はすべて、次の前提条件の上に成り立っています。これらが満たされなければ、以降の内容は役に立ちません。だからこそ、スプリントに入ってからではなく、契約前に確認しておく必要があります。
リファクタリングが適しているのは
- 業務を完全にそのまま維持する必要があり、顧客が何も変えたくないとき。
- ロジックが複雑で、全体を理解している人がもういないとき。だからこそ、人ではなく機械から正解を得る必要があるのです。
- 目的が業務の刷新ではなく、リスクの低減であるとき。
3つの必須条件
- 旧システムを動かす環境を構築できること。旧システムを動かせなければ、正解は得られません。
- マスキング済みの本番データ、またはトラフィックログを取得できること。
- 出力を毎回同じ条件で比較できること(決定性)。つまり、ランダムな要素や時刻に依存する要素を固定できること。方法は05章で説明します。
別の方式を検討すべきサイン
- 旧システムの環境を再構築できない:メインフレームのCOBOLがすでに停止している、フレームワークのサポートが終了している、ライセンスが残っていない。
- 業務を変える必要がある、あるいはUI・操作フロー・データ構造が大きく変わる。
- 旧コードに不要な処理が多すぎて、顧客がこの機会に業務を整理したいと考えている。
見落とされがちなリスク
旧システムの環境を構築できると確認しないままリファクタリングを選ぶのは、技術的な判断ではありません。それはプロジェクト全体を失敗させかねない、見積もりに織り込まれていないリスクです。私たちはこの確認を、Assessフェーズの完了条件にしています。評価の観点と報告書の中身は「レガシーシステムアセスメントの評価7領域」で詳しく解説しています。
03 マイグレーションテストをどこに置くか:コード構造がまもなく消えるとき
これはリファクタリングで最も難しい問いであり、多くのプロジェクトがテスト予算を無駄な作業に使い果たしてしまうポイントでもあります。
パラドックス
旧構造に沿ってテストしてはいけない。その構造は削除されます。テストも一緒に失われ、しかも最も必要なタイミングで消えてしまいます。
新構造に沿ってテストしてもいけない。それはまだ存在しません。新コードができてからテストを書くのでは、そのテストが証明できるのは「新しいものは新しいものと同じ」ということだけです。
解決策:持続するシーム(接合点)
シームとは、両方のバージョンに存在し、リファクタリングで消えない接合点のことです。英語の文献ではseamと呼ばれます。典型的な業務システムでは、シームは次のような場所です。
- HTTPエンドポイント、APIのエントリポイント
- メッセージキュー、トピック
- ファイル出力:帳票、取引先への送信ファイル、バッチファイル
- ストアドプロシージャのインターフェース
- 業務ユースケースのエントリポイント
- 他システムが直接読み込んでいるテーブル
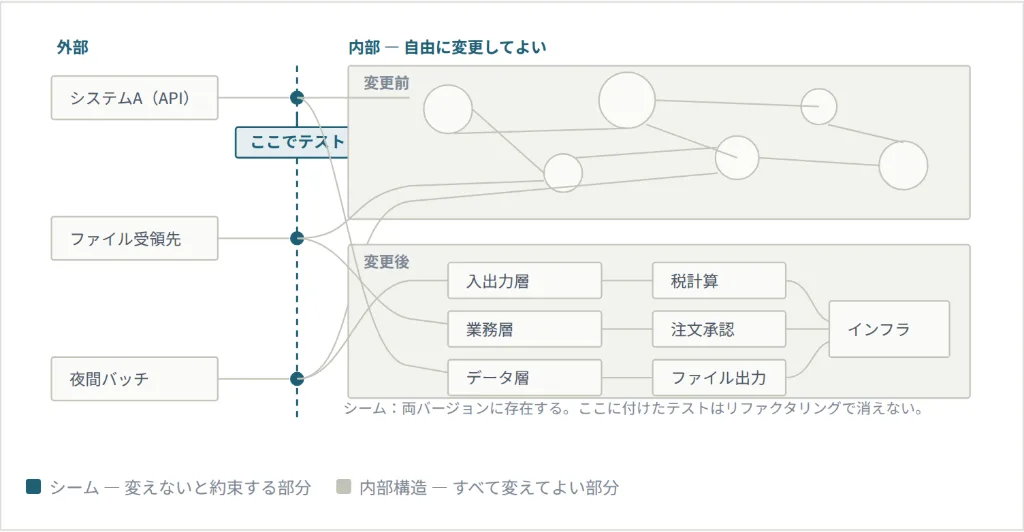
なぜ構造に沿ってテストしないのか。「変更前」にある6つの円はすべて削除され、それらに向けて書いたテストもすべて道連れになります。左側の3つのシームは両バージョンに存在します。リファクタリングの全工程を通じてテストスイートが生き残れるのは、そこだけです。
シームの特定方法
これは人間がやらなければならない作業です。AIには代行できません。その理由は07章で述べます。
- モジュールを呼び出している、あるいはモジュールの出力を読んでいる外部のものをすべて洗い出す。
- それぞれについて「リファクタリング後も、そのままの形で存在するか?」と問う。存在するなら、それがシームです。
- 境界線を引く。境界の内側は自由に変えてよく、外側は約束事です。
- 文書化し、顧客の確認を得る。
その境界線こそが「リファクタリング成功」の定義です。これがなければ、結果を比較する段階になって、ある差異がバグなのか許容されるものなのかを誰も裁定できません。
直感に反する帰結
リファクタリングでは、結合テストのほうが単体テストより価値があります。そして単体テストのカバレッジが高いことは、ときに悪い兆候です。テストがまもなく消えるものにしがみついている、ということを示しているからです。
言い換えれば、従来の指標は不十分であるばかりか、プロジェクトを誤った方向へ導きかねません。カバレッジのKPIを追うチームは、まもなく消えるコードのための単体テストに工数を注ぎ込み、本当に守るべき場所を手薄なままにします。これが08章の測定フレームワークの出発点です。
シームより深くテストすべきとき
上の原則は絶対ではありません。より下の層まで降りるべきケースが2つあります。
- 純粋な計算ロジック——税、利息、丸め、按分——で、その関数がそのまま残る、あるいはそのまま新システムへ移される場合。
- シームが粗すぎるモジュール:たったひとつのエンドポイントが5,000行のコードを呼び出している場合。このときは、まず中間のシームを作り、そこでテストします。
- 共通のルール:その層がリファクタリング後も確実に生き残る場合にだけ、より深くテストする。
04 マイグレーションテストの作業順序:テストがコードより先
これがプロジェクト全体の骨格です。注目すべきはステップそのものではなく、リファクタリングのコードを書き始める前に置かれた2つの評価ステップです。
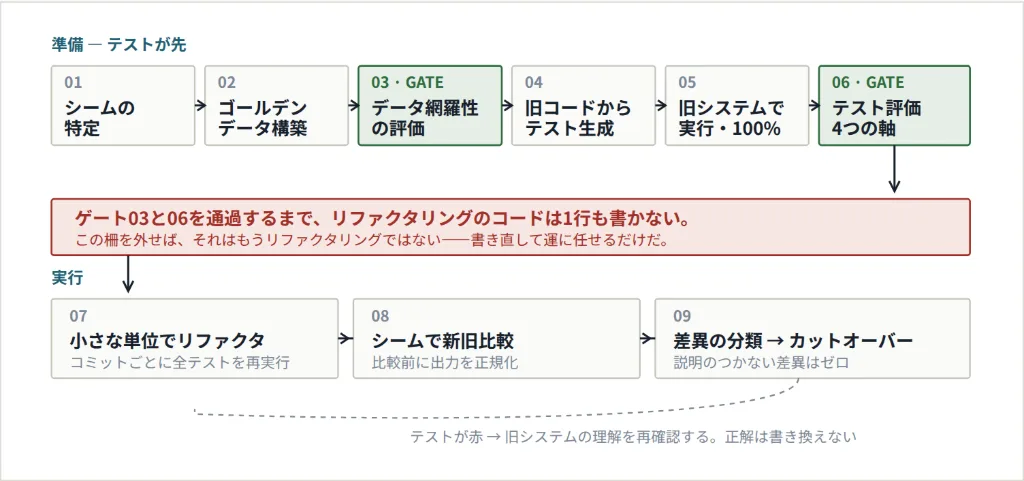
赤い線の手前にある2つのゲート。多くのプロジェクトでは、ステップ03と06は存在しません。集まったデータをそのまま使い、テストスイートは緑になった時点で完成とみなされます。
この2つのステップこそが、統制の取れたマイグレーションと「形だけテストがある」プロジェクトを分けるポイントです。
プロジェクト全体で最も重要なゲート
リファクタリングの前に、旧システム上でテストが100%緑であること。
このステップはテストのためのものではありません。自分たちが旧システムを正しく理解しているかどうかを確かめるためのものです。旧システム上でテストが赤になるということは、旧システムの振る舞いに関する自分たちの仮定が間違っていたということであり、その後の比較はすべて意味を失います。このステップを飛ばすなら、それはリファクタリングではありません——書き直して運に任せているだけです。
05 ゴールデンデータ:正解は推測するものではなく、記録するもの
ゴールデンデータとは、サンプル入力と、それに対応して旧システムから記録した出力のセットであり、以降のすべての比較で基準となる正解として使います。
新旧を比較するという発想自体は新しくありません。新旧比較テストは、日本のプロジェクトでは広く行われています。違いは、多くのプロジェクトがそれを終盤の作業として使っている点です。コードを書き終えてから比較し、何千件もの差異が出て、本番稼働前の2週間に人海戦術で処理する——というやり方です。
私たちのやり方は3つの点で異なります。それが05章と06章の内容です。
- ゴールデンデータはコードを書く前に構築し、終盤の検証ツールではなく、テストへのインプットとして使う。
- 各データケースにメタデータを持たせ、後で網羅性を評価できるようにする。メタデータがなければ何も測れない。
- データセットそのものに対する網羅性評価のステップを独立して設け、ギャップごとに3つの結論のいずれかを必ず出す。
なぜリスクと工数の両方を減らせるのか
リスクの面では、正解は旧システムから一度記録したら固定されます。担当者ごとの理解によって揺らぐことはなく、テストを書く人が期待値を推測することもありません。顧客から結果について問われたときは、具体的な証拠で答えられます。「この入力からこの出力が出た」「旧システムのどのバージョンで、いつ、どの環境で記録したか」という形です。しかも入力は実データから取るため、手でテストを書いていたら誰も思いつかなかったケースまでカバーできます。
工数の面では、レガシーコードのテストで最も時間がかかるのは、ケースごとに期待値を書く作業です。ゴールデンデータはこの作業を丸ごと不要にします。テストケースを1件追加することは、テスト関数を1本書き足すことではなく、入力を1行足すことになります。そしてリファクタリングで何かが壊れたときには、どのケースが壊れたかが即座に示されるため、手探りでデバッグする必要がありません。
入力をどこから取るか
| 入手元 | 長所 | 短所 |
|---|---|---|
| 本番ログ、トラフィックキャプチャ | 最も実態に近い。誰も思いつかない奇妙なケースまで含まれる | 分布が大きく偏る:ほぼすべてが通常ケース |
| 本番DBのスナップショット | 実データの組み合わせが揃い、テーブル間の関係も正しい | データ量が大きい。マスキングと絞り込みが必要 |
| コード内の条件分岐に沿って生成 | 本番には存在しない稀なケースもカバーできる | コードの読解が必要。業務上ありえない入力を生成しやすい |
| 業務部門から提供されたデータ | 業務上の意味が正しく、顧客も信頼する | 件数が少なく、たいてい正常系のみ |
4つの入手元はすべて組み合わせる必要があります。本番ログだけでは境界ケースがすべて抜け落ち、コードからの生成だけでは実態のケースがすべて抜け落ちます。06章が存在するのは、まさにこのためです。
何件選ぶか:2層戦略
CIのたびに数百万件のレコードを流すことはできません。私たちは2つの層に分けています。
- 高速層——数百件、コミットごとに実行、10分以内。ランダムではなく、分岐網羅と業務種別の網羅を基準に選ぶ。
- フル層——数万件から数百万件、毎晩またはマイルストーンの前に実行。
10分というしきい値は根拠のない数字ではありません。これを超えると、開発者はコミット前にテストを流さなくなり、どの指標が良好に見えても、安全網は機能しなくなります。
守らなければゴールデンデータが負債になる6つの必須事項
- ランダム要素と時刻依存の要素をすべて固定する。now()、random()、自動採番ID、UUID、セッション番号。固定しなければ実行のたびに出力が変わり、ゴールデンデータは役に立ちません。方法:疑似的な時刻を注入する、randomのシードを固定する、自動生成されるIDを比較対象から切り離す。
- 出力の正規化レイヤーを独立して持つ。日付フォーマット、行末の空白、キーが重複する場合のレコード順、JSONのキー順、タイムゾーン、浮動小数点数。このレイヤーで偽差異の大半を解消できます。一度書いたらプロジェクト全体で使い、次のプロジェクトにも引き継ぎます。
- マスキングは一貫性を保つ。誤ったマスキングは結果を狂わせます。顧客名がソートに関わっている場合、名前を置き換えると出力の順序が変わります。原則:長さ、文字種、テーブル間のキーの関係を維持する。
- バージョンで管理する。正解が旧システムのどのバージョンで、いつ、どの環境で記録されたかを明記します。正解を更新するたびに承認者が必要です。
- データをリポジトリから切り離す。リポジトリには高速層だけを置き、残りは外部ストレージに置きます。
- 各ケースに作成時点でメタデータを付与する——これが要です。このケースはどの分岐をカバーするか、どの業務ルールに属するか、Normal/Boundary/Abnormal(正常系/境界値/異常系)のどれか、どのテスト対象に属するか。このメタデータがなければ06章と08章では何も評価できず、数十万件に後からラベルを付けるのは非常に骨の折れる作業です。
2つの落とし穴
第一の落とし穴。ゴールデンデータは、バグも含めて現在の振る舞いを記録します。リファクタリングではこれが意図どおりですが、顧客には文書で明確に伝えておく必要があります。そうしないと、UATの段階で顧客から「なぜ古いバグがまだ残っているのか」と問われます。
第二の、より巧妙な落とし穴。テストが赤になると、ゴールデンデータを更新して緑に戻したくなるのが自然な反応です。これを何度か繰り返すと、安全網として機能しなくなります。ルール:正解を更新するたびに、理由と承認者を必ず記録する。
06 ゴールデンデータの網羅性評価——多くのプロジェクトが飛ばすステップ
本番から取ったゴールデンデータは、本質的に分布が偏っています。頻繁に起きることは大量にあり、めったに起きないことはほとんどありません。そしてマイグレーションのバグは、まさにその「めったに起きない」部分に集中します。
ゴールデンデータが50万件あっても、網羅性が高いとは限りません。そのうち49万件が同じコード分岐をテストしているかもしれないのです。
ケースの件数は指標ではありません。指標とは、何をカバーできていて、何が欠けているかです。
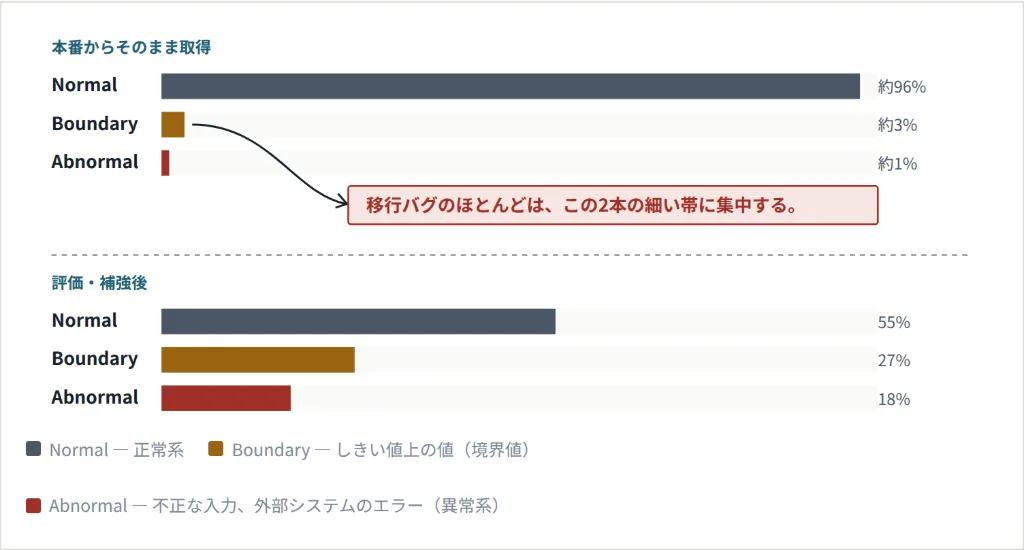
図の比率は説明のためのもので、特定プロジェクトの実測値ではありません。ただし形はどのプロジェクトでも繰り返されます。本番環境では許可された処理しか実行されないため、Abnormalのケースはほぼゼロになります。上位層が不正な入力を旧システムに届く前にすべて弾いているからです。下半分の目標比率は、プロジェクト全体で共通の数字を使わず、モジュールの種類ごとに個別に設定します。
ここにも原則上の違いがあります。データセットは、十分に集まった時点で完成とはみなしません。評価が済み、すべてのギャップに結論が出た時点で完成とみなします。
4つの軸で測る
08章の測定フレームワークと同じ4つの軸を使いますが、テストではなくデータに適用します。
- コード分岐の網羅。ゴールデンデータ全体を、カバレッジ計測ツールを付けて旧システム上で実行する。どのケースも到達しない分岐はギャップです。
- 業務ルールの網羅。各ケースをルールに対応付ける。ケースがひとつもないルールはギャップです。
- ケース種別の網羅。Normal、Boundary、Abnormalの比率を数える。本番由来のデータは、ほぼ例外なく後の2種類が大きく不足しています。
- データの組み合わせの網羅。重要な状態:新規顧客、ロック済みの顧客、キャンセル済みの注文、現行の制約を満たさない過去データ。
ギャップの分類と対処法
下の表の要点は、ギャップの種類ごとに対処法が異なり、しかもある種類については補充するのではなく結論を出す、という点です。
| ギャップ | よくある原因 | 対処法 |
|---|---|---|
| どのケースも到達しないコード分岐 | デッドコード | ケースは追加しない。デッドコードであることを確認して文書に記録し、マイグレーションの範囲から除外する。これは価値ある結論であり、失敗ではない |
| どのケースも到達しないコード分岐 | 稀なケース:決算期末、不正データ、緊急時のフロー | 入力を手作りするか、方向性を持たせて生成する。業務リスクの高さで優先順位を付ける |
| どのケースも到達しないコード分岐 | 特殊な環境条件が必要:特定の日付、外部システムの特定の状態 | 疑似時刻を注入し、外部システムのスタブを用意する |
| ケースがひとつもない業務ルール | めったに使われない業務、または紙の上にしか残っていないルール | まだ使われているかを業務部門に確認する。使われていれば補充し、使われていなければ文書に記録する |
| Boundaryケースの不足 | 本番には境界上の値が少ない | コード内の条件から方向性を持たせて生成し、日本の業務向け境界ケースライブラリからも取り込む:月末、決算期末、うるう日、改元、税率の変更日、フィールドの最大長 |
| Abnormalケースの不足 | 本番では上位層で弾かれるため、旧システムは不正な入力を一度も受け取ったことがない | 最も不足しがちで、最も重要な種類。手作りが必須:NULL、空文字、長さ超過、型違い、特殊文字、負の数、テーブル間で不整合なデータ |
| ひとつの分岐に重複ケースが多すぎる | 本番データの性質 | フル層に回して間引き、高速層には代表ケースだけを残す。網羅性を落とさずにCI時間を短縮できる |
必須の3つの結論
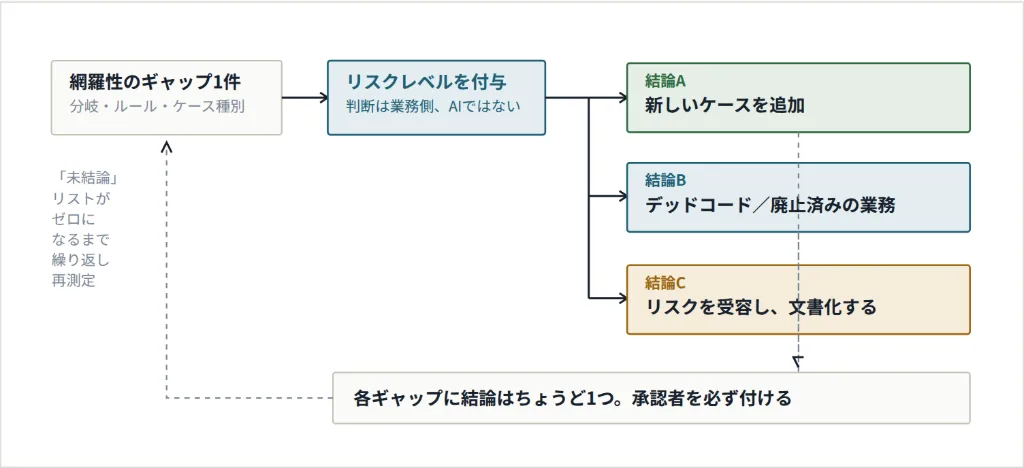
どの結論も失敗ではありません。結論B——ある分岐をデッドコードと確認して範囲から除外すること——は、テストケースを補充するよりも多くの工数を削減することがよくあります。唯一許されないのは、ギャップを結論の出ていない状態のまま放置することです。
完了条件
100%網羅する必要はありません。必要なのは結論の出ていないギャップがひとつも残っていないことです。これは実現可能で、1行ずつ確認できる基準です。根拠の説明がないパーセンテージよりも、日本のお客様に高く評価される約束の形です。
このステップでAIにできること
ここは、ゴールデンデータのプロセス全体の中でAIが最も役に立つ場面です。
- 旧コードを読んで条件分岐をすべて洗い出し、既存のケースに対応付けて、未カバーの分岐リストを即座に作る。手作業では何日もかかる作業です。
- コード内の条件から、方向性を持たせてBoundaryとAbnormalのケースを生成する。退屈なうえに丁寧な読解が求められる作業——まさにAIが得意とする領域です。
- 既存のケースをNormal、Boundary、Abnormalに分類して比率を測る。
- 重複ケースを提示し、高速層の間引きを助ける。
一方、AIにできないのは、ギャップの業務リスクの評価と、リスク受容の判断です。それはPM、BrSE、そして顧客の仕事です。
自社のコードで、マイグレーションテストの出発点を確認する
HBLABの無料AI診断は、対象コードを解析して業務ロジック・依存関係・移行リスクを可視化し、単体テスト・結合テストまでの移行パイプラインで検証します。先着10社限定・費用無料。
07 テスト技法と、AIの本当の役割
以下の技法は業界の共有知識であり、誰かの発明ではありません。違いを生むのは、それらを適用する順序と、その間に置かれたゲートです。
- 現在の振る舞いを記録するテスト(characterization test、golden master)——旧システムの写真を撮って原本とし、正誤は判断しない。
- シームでの新旧比較(新旧比較テスト)——同じ入力を与え、境界で出力を比較する。
- ミューテーションテスト——テストが本当にバグを捕まえられるかを検証する。詳細は08章。
- ファイル・帳票の比較(approval test)——ファイル、PDF、CSV、取引先への送信ファイルといった形式の出力向け。
- 性質に基づくテスト(property-based test)——丸め、利息計算、按分、税などの純粋なロジック向け。
- 段階的な置き換えと並行稼働(strangler fig、shadow run)——部分的にリファクタリングする場合。2つの系統を同時に動かし、実際の結果を書き込むのは旧系統だけ。
AIによるテスト生成パイプライン
→既存のゴールデンデータに対応付け、未カバーの分岐を見つける
→追加のBoundary・Abnormalケースを生成する
→テストを生成する
→旧システムで実行 →100%緑になるまで修正する
→4つの軸で測定 → 弱い箇所を補強する
→ここで初めてリファクタリングを開始する
AIが得意なこと
- 800行の関数を読んで条件分岐をすべて洗い出す——見知らぬコードに取り組むとき最も手間のかかる作業。
- コード内の条件から、方向性を持たせてBoundaryとAbnormalのケースを生成する。
- 出力の正規化レイヤーを構築する:細かなルールが大量にあり、AIは非常に速く書ける。
- 既存のゴールデンデータにメタデータのラベルを付ける。
- フィクスチャ、モック、スタブの生成。フレームワーク間のテスト移植。
AIが苦手なこと
- コードが間違っているとき、その意図を推し量れません。AIはバグまでそのまま固定するテストを書きます。リファクタリングではそれが意図どおりですが、自分がそうしていると自覚しておく必要があります。
- 隠れた状態。now()、セッション、DB、ジョブの実行順序、ファイルシステム。AIはこれらを見落としがちで、2回目には再現しないテストを生成してしまいます。
- 数千行のストアドプロシージャ。リフレクションやevalで動的に生成されるコード。
- どこが持続するシームなのかを自分では判断できない。人間が指し示す必要があります。これは本質的な限界であり、プロンプトの問題ではありません。
- 意味のあるassertを持たないテストを生成しがち——関数を呼んでカバレッジを上げるだけで、何も検証しない。08章の第4の軸が存在しなければならない理由は、まさにここにあります。
基本原則
同じAI、同じコンテキストで、コードのリファクタリングと、そのコードを検証するテストの生成を両方行ってはいけません。そうするとAIは検証される側であると同時に正解を出す側にもなり、テストが証明できるのは「AIが自分自身と一貫している」ということだけになります。
リファクタリングにおいて、独立した正解は旧システムです。このアプローチ全体を支えているのは、それです。
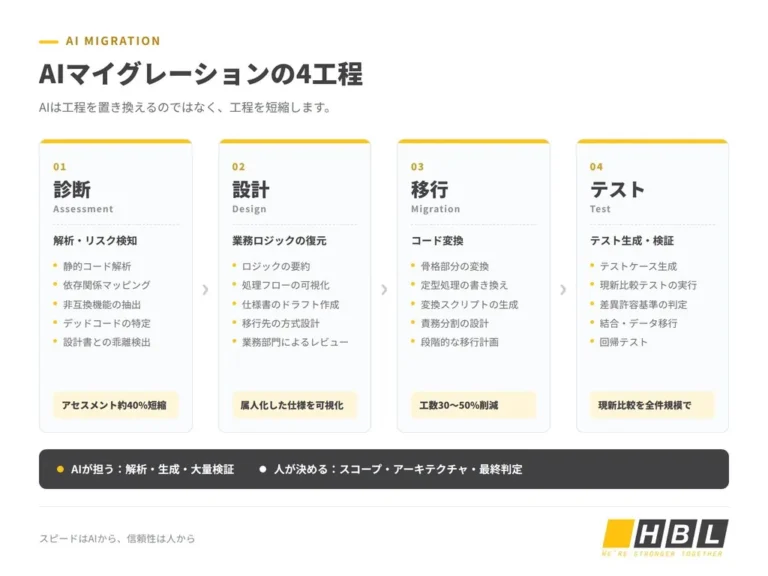
なお、診断・設計・移行・テストの各工程でAIに任せられる範囲と限界は、「マイグレーションのAI活用|工程別にできること・限界と品質担保」で整理しています。
08 Migurei Quality:マイグレーションテストを4つの軸で測る
多くのプロジェクトには、テスト品質の指標がひとつしかありません。コードカバレッジです。そして指標がひとつしかないために、4種類の異なるギャップが見えなくなっています。
リファクタリング案件におけるコードカバレッジの3つの問題
- 測る対象を間違えている。カバレッジが測るのは実行されたコード行であって、検証された振る舞いではありません。すべての関数を呼ぶだけで何もassertしないテストスイートでも100%になります。
- 業務が見えない。顧客が本当に知りたい「私たちの税計算ルールはどこでテストされているのか?」という問いに答えられません。
- リファクタリングに限っては、誤った方向へ導きさえする。単体テストのカバレッジが高いということは、テストがまもなく消える構造にしがみついているということです。
これはチームが不正をしているから起きるのではありません。人は測られるものに合わせて最適化するからです。ひとつの指標だけを使えば、必ずそれに対応するごまかし方が生まれます。
Migurei Qualityは、ひとつのカバレッジの数字を報告する代わりに私たちが使っている測定フレームワークです。各軸は、業界ですでに名前の付いた技法に基づいています。私たちが行ったのは、4つの軸を閉じたフレームワークとして組み合わせ、モジュールの種類ごと・テスト対象ごとに具体的なしきい値を設け、それを終盤のレポートではなく進行を止めるゲートとして使うことです。
| 軸 | 問い | 測定方法 | 検出できるもの | 検出できないもの |
|---|---|---|---|---|
| 軸1 Code coverage |
テストはコードの分岐を十分に通っているか? | カバレッジツール — 行、分岐、条件 | 一度も実行されたことのないコード | 通過するだけで何も検証しないテスト。テストされていない業務 |
| 軸2 Branch / Spec coverage |
テストは業務要件に即しているか? | ルールIDとテストIDを対応付け、テストのないルールを数える | コードは通過していても、検証されていない業務 | 書き出されていないルールは測れない |
| 軸3 Test category coverage |
ケースの種類は揃っているか? | Normal : Boundary : Abnormal の比率 | 正常系ばかりのテストスイート | 個々のケースの品質 |
| 軸4 · リファクタリングで最も重要 Test quality coverage |
テストスイートは信頼できるか? | ミューテーションスコア、assert密度、assertのないテストの割合、フレーキー率、重複テスト | 存在はするがバグを捕まえられないテスト | テストが足りない場所については何も語らない |
4つの軸は論理的な順序で並んでいます。実行されているか → 業務に即しているか → ケースの種類が揃っているか → 本当にバグを捕まえるか。各軸は必要条件であり、どの軸も単独では十分ではありません。ひとつの軸を外せば、ちょうど1種類のギャップが開き、そのギャップは残りの3つの軸には現れません。
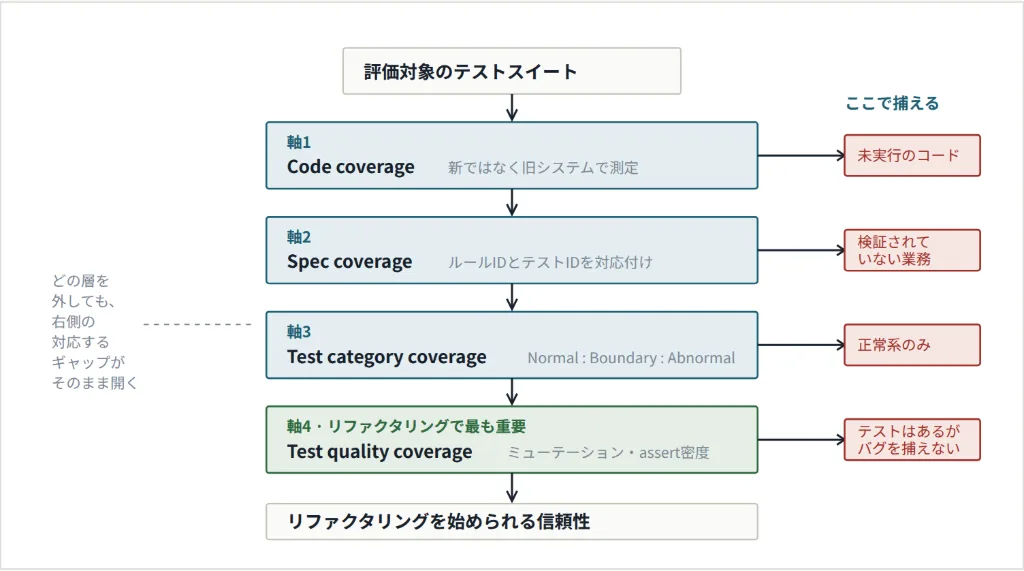
4本の並行したレポートではなく、直列につながった4層のフィルタ。4つの層すべてを通過したテストスイートだけが、安全網として信頼できます。右側の列は、各層が——そしてその層だけが——見つけられるものです。
各軸の詳細
軸1 — Code coverage
行カバレッジだけでなく、分岐カバレッジを測ります。行は高いのに分岐が低いのは、正常系しか通らないテストの典型的な兆候です。リファクタリングでは、私たちは新システムではなく旧システム上で測定します。目的は、ゴールデンデータとテストが旧コードをすべて通っているかを確認することです。新システム上のカバレッジは、構造が変わっているためあまり意味がありません。これは一般的なやり方とはまったく異なる取り決めです。しきい値はリスクの高さに応じて段階的に設定します。業務の中核は分岐90%以上、外側の層はそれより低く、除外リストは明示的に公開します。
軸2 — Branch / Spec coverage
番号付きのルール一覧と、ルールIDとテストIDの対応表が必要です。リファクタリングでは、ルールはたいてい書き出されていないため、コードの分岐から導き出す必要があります。ただし完全なドキュメントは不要で、対応付けに足るモジュール単位のリストがあれば十分です。この軸は、日本のお客様にとって最も説得力のある軸です。お客様が関心を持っている問いに直接答えるからです。さらに副次的な価値もあります。対応付けの過程で、どのルールにも属さないコード分岐——つまりデッドコードや見落とされたルール——が自然に見つかります。
軸3 — Test category coverage
ケースは3種類です。Normalは正当な入力、通常のフロー。Boundaryはしきい値上の値——ちょうど上、ちょうど下、ちょうど等しい値。月末、決算期末、うるう日、改元、税率の変更日、フィールドの最大長。Abnormalは不正な入力、外部システムのエラー、タイムアウト、不整合なデータ、途中停止です。
目標比率はプロジェクト全体で共通の比率を使わず、モジュールの種類ごとに設定します。入力系のモジュールにはAbnormalが多く必要で、計算系のモジュールにはBoundaryが多く必要です。表示だけのモジュールならNormalが大半を占めるのが妥当です。この軸がリファクタリングで特に重要なのは、ゴールデンデータが本番由来であるため、放っておけばほぼNormalだけになるからです。その偏りを見つけ出すのが、まさにこの軸です。
軸4 — Test quality coverage
これはリファクタリングで最も重要な軸です。構造を変えていく全工程を通じて、テストスイートが唯一の安全網だからです。網に穴があっても、本番で障害が起きるまで誰も気づきません。
主要な指標はミューテーションスコアです。意図的にコードにバグを埋め込み、そのうち何パーセントをテストが捕まえるかを数えます。テストがバグを捕まえられるかどうかを直接測る唯一の方法です。ミューテーションテストは時間がかかるため、対象を絞って実行します。リファクタリング予定の業務中核モジュールと、各マイルストーンの前です。
ミューテーションを実行する前に、安くて速い補助指標をいくつか先に測るべきです。意味のあるassertをひとつも持たないテストの割合(AIが生成したテストの典型的な病)、ケースあたりのassert密度、フレーキー率、重複テストの割合、そして高速層の実行時間です。フレーキーなテストは、テストがない状態よりも悪影響が大きいものです。チーム全員に赤を無視することを教えてしまうからです。
測定はゲートとして、リファクタリングの後ではなく前に行います。後で測っても手遅れです。テストがすべて通ることと品質が証明されることの違いは、「テストが「PASS」でも、それだけでは品質を証明できない理由」でも取り上げています。
各軸は1種類のごまかしを防ぐ
| これだけを使うと… | 品質を上げずに目標を達成する方法 | それを防ぐ軸 |
|---|---|---|
| Code coverage | すべての関数を呼ぶだけで、何もassertしないテストを書く | Test quality |
| Branch / Spec coverage | ルールごとに正常系のテストを1本ずつ書き、条件違反のケースはすべて省く | Test category |
| Test category coverage | 簡単な部分にAbnormalケースを大量に作り、中核部分は空けたままにする | Code coverage と Spec coverage |
| Test quality coverage | コードのごく一部でミューテーションスコアを高くする | Code coverage |
4つの軸をテスト対象の種類ごとに適用する
4つの軸は業務ロジックだけのものではありません。あらゆる種類の対象に適用でき、すべてに適用してはじめて、テストスイートが深さだけでなく幅も網羅していることが示されます。
| 対象 | 検証すべきこと | 不足が最も見つかりやすい箇所 |
|---|---|---|
| 業務ロジック | 金額の計算式、税のルール、承認条件、営業日の計算方法 | Boundary:しきい値のすぐ上と下の値、税率の変更日、改元 |
| データ | 件数突合、列ごとのチェックサム、金額列の合計、データ型と小数の精度、varcharの切り捨て、外部キーの整合性、スクリプトを2回流したときにデータが二重にならないか | Abnormal:制約を満たさない過去データ、テーブル間で不整合なデータ |
| API これ自体がシームであり、絶対に変えてはならない約束 |
リクエストとレスポンスのスキーマ、ステータスコード、エラーのフォーマット——最も見落とされる箇所、ヘッダー、ページング、エンコーディング、認証とセッション、タイムアウト | Abnormal:エラー経路、タイムアウト、トークン期限切れ。Spec coverage:バリデーションルールはめったに対応付けられない |
| バッチ | 固定長ファイルのレイアウト、エンコーディング、改行コード、全角文字のバイト数、締め時刻、業務日付とシステム日付、途中停止と再実行、ジョブ間の依存順序、同時実行 | BoundaryとAbnormalの両方が最も不足する。バイト単位の比較が最も必要な場所 |
| 外部システムとのインターフェース | 実際のトラフィックを記録して再生する(第三者側にはテスト環境がないことが多いため)。リトライ、重複メッセージ、メッセージの順序 | Abnormalはほぼ皆無。本番ではそうしたケースがめったに発生しないため |
4軸のレポートを業務ロジックだけで測り、バッチや外部システムとのインターフェースで測らなければ、きれいな数字がちょうど最もリスクの高い2箇所を覆い隠すことになります。そのため、レポートは対象ごとに分けて作成し、システム全体でひとつの数字にまとめないようにします。
4つの軸はレポートではなく、ゲートとして使う
これが一般的なやり方との最大の違いです。指標は、先へ進むことを止められるときにだけ価値を持ちます。
| # | ステップ | 完了条件 |
|---|---|---|
| 01 | Assess | モジュール一覧、リスクレベル、そしてモジュールの種類ごと・テスト対象ごとの4軸のしきい値——PMとBrSEが署名する。旧システムの環境を構築できることを確認する。 |
| 02 | シームの特定 | 境界線が引かれ、顧客が確認している。これが「リファクタリング成功」の定義。 |
| 03 | ゴールデンデータの構築 | マスキング済みでバージョン管理され、全ケースに十分なメタデータがあるデータセット。 |
| 04(ゲート) | ゴールデンデータの評価と補強 | 結論の出ていないギャップがひとつもない。 |
| 05(ゲート) | テストを生成し、旧システムで実行 | 旧システム上でテストが100%緑。 |
| 06(ゲート) | 4つの軸でテストスイートを評価 | テスト対象ごとに4つの軸がしきい値を満たしている。残る弱点にはすべて判断が下されている。リファクタリング予定のモジュールでミューテーションスコアがしきい値を満たしている。 |
| 07 | リファクタリング | コミットごとに小さな変更。変更したコードの100%にテストが到達する。リスクの高さに応じたレビュー。 |
| 08 | シームでの新旧比較 | 一致率がしきい値に達している。 |
| 09(ゲート) | 差異の分類 | 説明のつかない差異がひとつもない。 |
| 10 | 並行稼働、カナリア、カットオーバー | ロールバックのリハーサルが済んでいる。 |
上で色付けされた4つのゲートは、省略してはならない4箇所です。そして測定は一度きりではなく、マイルストーンごとに繰り返します。
→弱点を具体的に列挙する:どの分岐が未カバーか、どのルールにテストがないか、
どの対象でAbnormalが足りないか、どのミューテーションが捕まっていないか
→各弱点に業務リスクのレベルを付ける
→リスクの高い順に補強する、またはリスク受容を文書化する
→再測定
顧客への回答:「単体テストのカバレッジを100%パスさせるには?」
この質問は2つの異なる概念をひとまとめにしており、まずそれを切り分けることが先決です。テスト100%パスは必須であり、実現可能であり、交渉の余地はありません。コードカバレッジ100%は誤った目標です。理由は本章の冒頭で述べた3つのとおりです。
私たちの提案は、ひとつの数字を、テスト対象ごとに分けた4つの数字に置き換え、さらに「〜がゼロ」という形の2つの条件を加えることです。結論の出ていないゴールデンデータのギャップがゼロであること、そして説明のつかない差異がゼロであることです。
それでも社内資料のために100%のKPIが必要だという場合、それを誠実に達成する方法は、除外リスト——自動生成コード、DTO、設定——を明示的に公開し、残り3つの軸を併記してその数字に意味を持たせることです。
顧客へのレポートは1ページです。テスト対象ごとの4つの数字、残る弱点のリスト、それぞれへの対処の判断、そして承認者。より信頼できるというだけでなく、実利的な価値もあります。4つの数字と弱点リストがあれば、顧客は予算を判断できるのです。どこがまだ守られていないか、追加投資に値するかがはっきり見えます。98%という数字ひとつでは、何も判断できません。
4つの軸は、AIが生み出すものに対する防御層
多層防御の連鎖は、シームでの新旧比較、4つの軸、静的解析と型チェック、リスクに応じた人のレビュー、そして並行稼働です。4つの軸は中心の層であり、各軸がAIの異なる種類の問題を防ぎます。
- Test qualityの軸は、AIが生成したテストの典型的な病を直接防ぎます。存在はするが何も検証しないテストです。私たちは、AIが生成したテストのうち測定後に除外されたものの割合を算出し、公開しています。
- Spec coverageの軸は、AIが生成したコードの問題を防ぎます。AIはリファクタリング中に「ついでに」振る舞いを変えてしまいがちです。すべてのルールがテストに対応付けられていれば、意図しない振る舞いの変更は捕まります。
これに加えて双方向のトレーサビリティ——シーム ↔ テスト ↔ コミットとルール ↔ テスト ↔ コミット——を持たせ、顧客からあるルールがどこでテストされているかを問われたとき、10秒で答えられるようにします。さらにコミットごとの変更量を管理します。1つの変更に1つの目的。差分が小さいからこそ、差異を正しいコミットまで遡れるのです。そしてAIが生成したコード専用のレビューチェックリストを用意します。見慣れないライブラリの追加、簡略化されたエラー処理、テストから持ち込まれたハードコード値、実際の振る舞いと食い違うコメント、コードに紛れ込んだシークレット。
AIは生産性を高めますが、責任を移すことはありません。署名するのは、あくまでQCリードです。
このフレームワークがプロジェクトを通じて蓄積するもの
このフレームワークは静的なドキュメントではなく、プロジェクトを重ねるごとに厚みを増していきます。蓄積される資産は3つです。
- 日本の業務向けBoundaryケースライブラリ:全角と半角、元号(令和、平成)、営業日カレンダー、複数税率の消費税、Shift_JISとCP932、波ダッシュ。プロジェクトごとに追加され、次のプロジェクトは初日から再利用できます。
- 出力正規化ライブラリ:一度遭遇した偽差異は、種類ごとに永続的に再利用できるルールとして書き起こされます。
- モジュールの種類・テスト対象ごとのしきい値セット:実プロジェクトのデータから導き出しているため、プロジェクトが増えるほど精度が上がります。
これはブログ記事を読んでもコピーできない部分です。技法は公開されています。しかし日本の業務向けの境界ケースライブラリと、校正済みのしきい値セットは、実際のプロジェクトという代価を払ってはじめて手に入るものです。
09 差異の分類:どれが本当のバグで、どれが許容できるのか
最初の新旧比較では、たいてい何千件もの差異が出ますが、その大半はバグではありません。分類できなければ、チームは偽差異に埋もれ、やがてすべてを無視しはじめます——本物の差異も含めて。
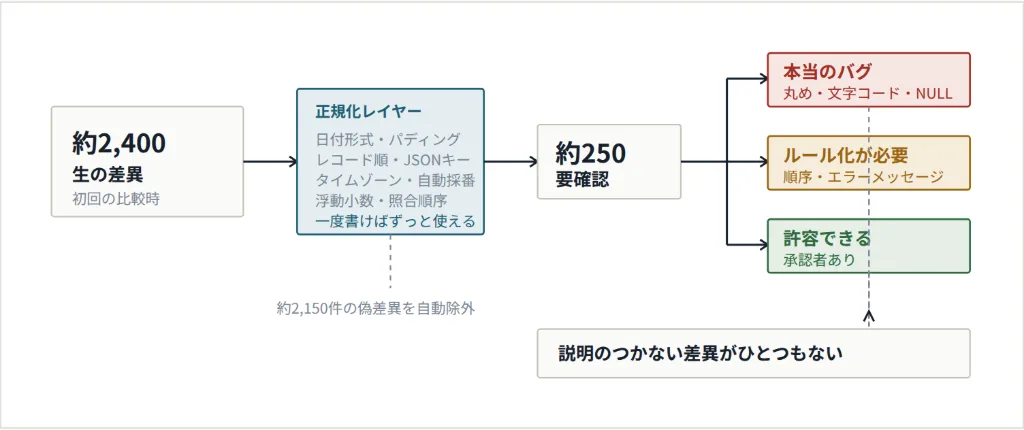
数字は説明用ですが、比率は実態どおりです。作業量の大半は正規化レイヤーが処理します。コードで書かれ、一度作れば以降のすべてのプロジェクトで再利用できるものです。このレイヤーがなければ、2,400件の差異すべてを、本番稼働前の2週間で人の目に通すことになります。
| 差異の種類 | 具体例 | 結論 |
|---|---|---|
| フォーマット | 2025/01/05と2025-1-5、1,000と1000、パディング、行末の空白 | 正規化 正規化後も差異が残り、シームの範囲内であればバグ |
| 丸め | 四捨五入と銀行丸め(half-even)、演算の順序、浮動小数点と十進数 | 常にバグ 決して許容しない |
| エンコーディング | CP932からUTF-8へ、〜(波ダッシュ)、①、全角と半角、BMP外の文字 | バグ |
| 順序と照合順序 | キーが重複する場合のレコード順、DBの照合順序(collation)の違い | ルール化が必要 下流システムが順序に依存していればバグ、そうでなければ正規化 |
| NULL、空文字、0 | DBエンジンを変えるときの定番パターン | バグ |
| タイムゾーンとタイムスタンプ | JSTとUTC、created_atの自然なずれ | 比較前に正規化 |
| IDとシーケンス | 2つの環境間で異なる自動採番 | 正規化 |
| JSONのキー順、配列要素の順序 | データの意味には影響しない | 正規化 |
| エラーメッセージの文言、UI | リファクタリング後に表示文言が変わった | ルール化が必要 リファクタリングでは、シームの範囲外であれば通常はバグ |
必ず用意すべき2つのもの
- 出力の正規化レイヤー。偽差異の大半を減らすものであり、次のプロジェクトでも再利用できる資産です。
- 顧客が文書で承認した差異分類ルール。これがなければ、差異に出会うたびに一から議論をやり直すことになり、判断はその場に誰がいたかで左右されます。
完了条件
説明のつかない差異がひとつもないこと。「許容できる」差異には必ず承認者が必要です——「とりあえず後で見る」状態に置いてはいけません。その状態は、二度と見直されることがないからです。
10 一般的なやり方と私たちのやり方
比較の内容の多くは、ここまでの各章にすでに散りばめられています。下の表はそれをまとめ、議論を締めくくるものです。
| 観点 | 一般的なやり方 | Migurei Quality |
|---|---|---|
| テストの正解 | テストを書く人が期待値を自分で推測する | 旧システムから記録したゴールデンデータ。バージョン管理され、更新時には承認が必要 |
| 新旧比較のタイミング | 終盤、コードを書き終えてから | コードを書く前。テストへのインプットとして |
| テストデータセット | 集まれば完成 | 網羅性評価のステップがあり、各ギャップに3つの結論のいずれかが必須 |
| 品質指標 | コードカバレッジの数字ひとつ | 4つの軸 × テスト対象ごと。モジュールの種類に応じたしきい値付き |
| 指標の役割 | 終盤のレポート | フロー内の4箇所で進行を止めるゲート |
| 日本の業務向け境界ケース | プロジェクトのたびに一から作る | 蓄積されたライブラリを初日から再利用 |
| 偽差異 | 本番稼働前に人海戦術で処理 | 出力正規化ライブラリと、承認済みの分類ルール |
| 納品成果物 | テストスイートとカバレッジレポート | バージョン管理されたゴールデンデータ、4軸レポート、差異分類ルール、顧客のCIで動くテストスイート、監査用のエビデンス一式 |
さらに補足しておきたい点が2つあります。ひとつはAssessフェーズです。モジュールがリファクタリング可能かどうかの評価——旧環境を構築できるか、コールグラフ、結合度、改修頻度、リスクレベル——と、シームの特定を、担当者任せではなく文書化されたプロセスに沿って行います。このステップを飛ばし、いきなりコードを書きはじめるベンダーも少なくありません。
もうひとつはツール群です。新旧比較のハーネス、モジュールごと・対象ごとの4軸ダッシュボード、そして画面設計書の生成や見積ファイルからのWBS生成といった繰り返し作業向けの社内スキル群です。
これらのツールと4つの軸による品質保証は、HBLABのマイグレーションサービスと、AI搭載のモダナイゼーションソリューション「Migurei」に組み込まれています。
まとめ:マイグレーションテストで持ち帰っていただきたい4つのこと
- テストはコード構造に沿ってではなく、持続するシームに置く。リファクタリングでは、単体テストのカバレッジが高いことは悪い兆候になりうる。
- リファクタリングの前に、旧システム上でテストが100%緑でなければならない。このステップが確かめるのはコードではなく、自分たちが旧システムを正しく理解しているかどうかである。
- ゴールデンデータは、マイグレーションで最もリターンの高い投資である——ただし、何をカバーし何が欠けているかを評価するステップがある場合に限る。評価されていないゴールデンデータは、本番データをコピーした山にすぎない。
- マイグレーション案件において、コードカバレッジは「テストは十分か」という問いに答えられない。必要なのは4つの軸であり、テスト対象ごとに分け、レポートではなくゲートとして使うことである。
第2回。旧システムの環境を構築できない場合、あるいは業務を変える必要がある場合、旧システムから正解を得ることはできません。そのときの正解は、顧客が確認した新しいドキュメントから来なければなりません——そして本稿の内容のほぼすべてが逆転します。作業の順序、テストの置き場所、最も恐れるべきバグの種類、そして4つの軸のうちどれが主軸になるか。それがリビルド編の内容です。
用語について:characterization test、golden master、mutation testing、strangler fig、property-based test、そして新旧比較テストは、業界ですでに名前が付いており、調べることのできる技法です。Migurei Qualityは、それらを閉じたフレームワークとして組み合わせた私たちのやり方です——4つの測定軸、モジュールの種類ごとのしきい値セット、進行を止めるゲート、そしてプロジェクトを通じて蓄積してきた境界ケースライブラリと出力正規化ライブラリ。
HBLABは、ベトナムの開発体制とAIを組み合わせ、日本企業のレガシーシステム移行を支援しています。旧システムを正解とし、4つの軸をゲートとして使う——リファクタリング型のマイグレーションテストをどこから始めるべきか迷ったら、まずは現行資産の診断からご相談ください。
マイグレーションテストの設計からご相談ください
ゴールデンデータの構築、4軸での品質評価、新旧比較まで、HBLABのモダナイゼーション支援がマイグレーションテストを一貫して支えます。