マイグレーションの進め方|アセスメント・AI移行・テストの3段階
マイグレーションの進め方を、アセスメント・AI移行・テストの3段階で解説。各段階の完了条件、AIと人の役割分担、現新比較による品質の証明方法まで紹介します。
マイグレーションの進め方|アセスメント・AI移行・テストの3段階 続きを読む
マイグレーションの進め方を、アセスメント・AI移行・テストの3段階で解説。各段階の完了条件、AIと人の役割分担、現新比較による品質の証明方法まで紹介します。
マイグレーションの進め方|アセスメント・AI移行・テストの3段階 続きを読む
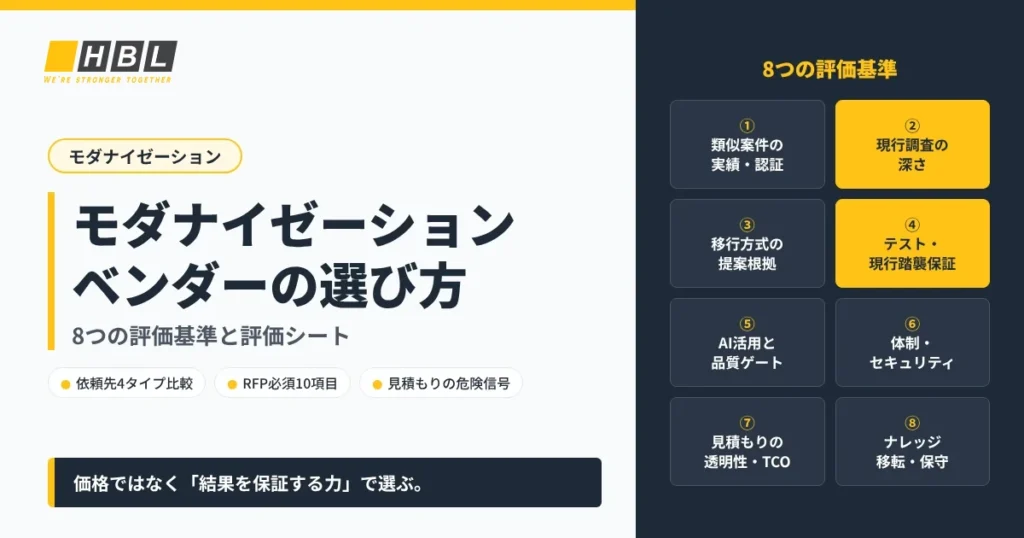
モダナイゼーションベンダーの選び方を、アセスメント力・テスト品質・AI活用など8つの評価基準で解説。システム移行ベンダーの比較に使える評価シート付き。
モダナイゼーションベンダーの選び方|8つの評価基準と評価シート 続きを読む
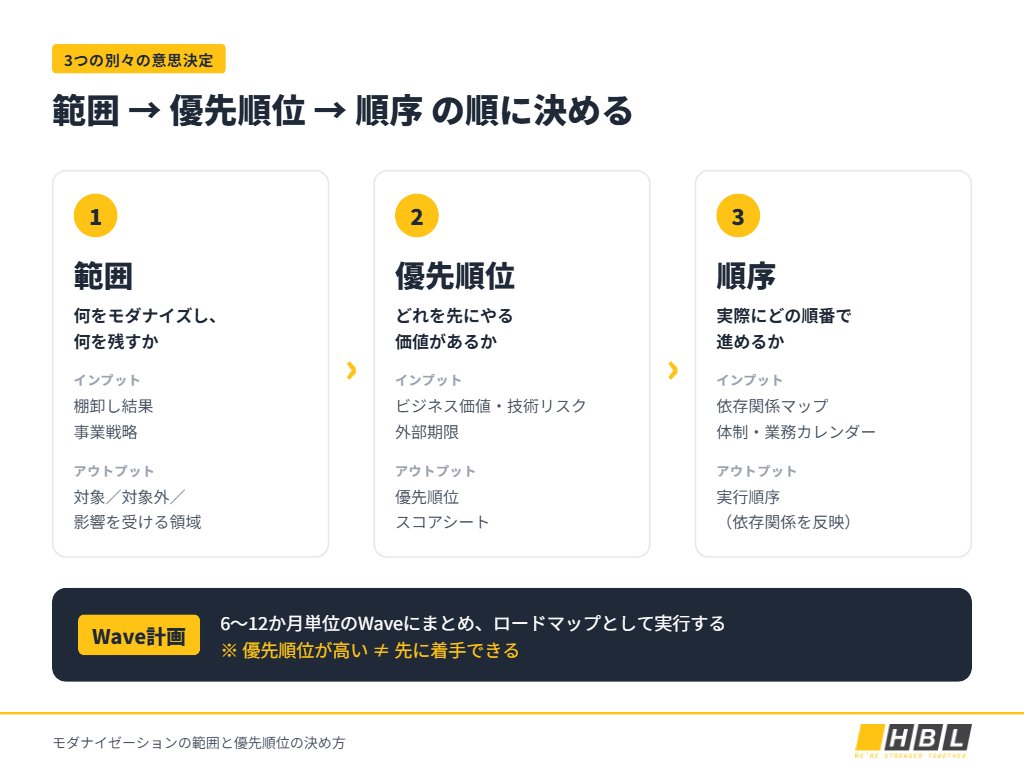
モダナイゼーションの優先順位と範囲はどう決める?評価軸のスコアリングと依存関係分析で着手順を決め、最初に移行するシステムの選定からWave設計まで解説。
モダナイゼーションの優先順位と範囲|着手順を決める3ステップ 続きを読む
アセスメントレポートは、移行前に「このシステムを、どの方式で、いくら・どの順番で移すか」を決めるための判断材料です。単なる調査結果の一覧ではありません。 📌 この記事の要点 移行(マイグレーション)前のアセスメントレポートは、少なくとも次の10の問いに答えている必要があります。①移行対象の本当の規模、②依存関係、③業務ロジックの所在、④データ品質、⑤難所とその理由、⑥モジュールごとの移行方式、⑦前提つきの工数・費用・期間、⑧リスクと対策、⑨進める順番、⑩移行後の正しさの証明方法です。 どの問いにも「根拠」「数値の前提」「未調査の範囲」が書かれていれば、稟議・ベンダー比較・移行計画にそのまま使えます。逆に、一覧表だけで結論がないレポートは、移行判断には使えません。本記事では、受け取る側の目線で、良いレポートと危ないレポートの見分け方まで整理します。 レガシーシステムのアセスメント全体の流れ(評価7領域・進め方・費用)は、レガシーシステムアセスメントの評価7領域と報告書の中身で解説しています。本記事はその中でも、「アウトプット=レポート」をどう読み、どう使うかに絞ります。関連テーマはモダナイゼーション記事一覧からもご覧いただけます。 アセスメントレポートとは?「調査結果の一覧」との違い アセスメントレポート(アセスメント報告書)とは、現行システムを調査・評価した結果をまとめ、移行の意思決定に必要な答えを示す報告書です。まず、よく混同される「調査結果の一覧」との違いから整理します。 レポートは「判断材料」— 移行の可否・方式・費用・順番を決める文書 現行システム調査では、ソースコード、DB、バッチ、外部連携などを洗い出します。しかし、洗い出しそのものはゴールではありません。 経営層や情シス部門が本当に知りたいのは、次の4点です。 このシステムは移行できるのか(可否) どの方式で移すのか(方式)
アセスメントレポートが移行前に答えるべき10の問いと見極め方 続きを読む
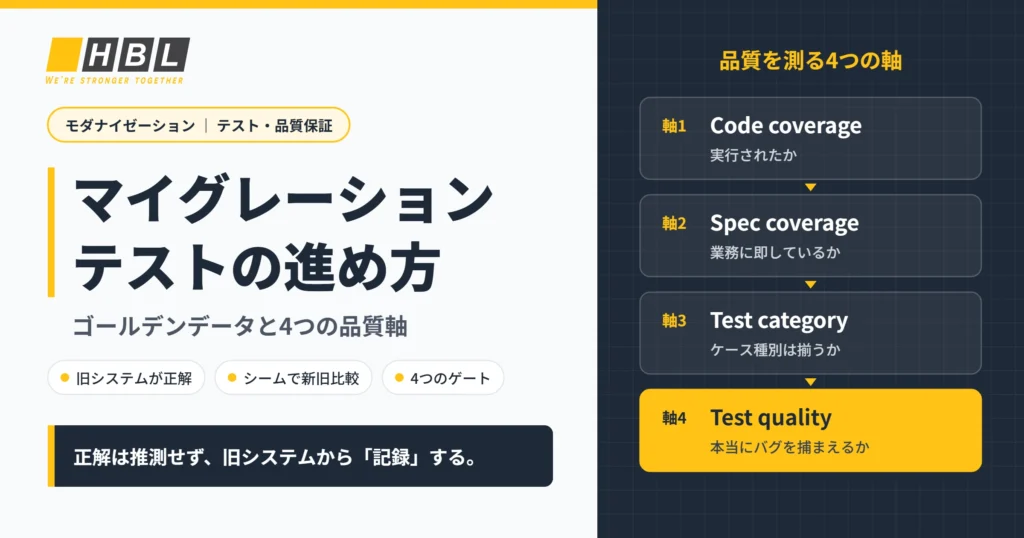
マイグレーションテストとは、既存システムを新しい環境・構造へ移行する際に、移行後のシステムが移行前と同じ業務結果を出すことを検証するテストです。リファクタリング型のマイグレーションテストでは、失われた仕様書ではなく旧システムそのものが正解になります。旧システムの出力を「ゴールデンデータ」として記録し、新旧で消えない接合点(シーム)で比較する。そして品質はコードカバレッジひとつではなく、Code・Spec・Test category・Test qualityの4つの軸で、リファクタリングを始める前に測ります。 本記事では、HBLABが実際のマイグレーション案件で使っているマイグレーションテストの進め方を、テストの置き場所、ゴールデンデータの作り方と網羅性評価、AIの役割、差異の分類まで順に解説します。 リファクタリング案件では、仕様書は多くの場合失われているか、いま動いている実態と合わなくなっています。信頼できる唯一の正解は旧システムそのものです。正解の出どころが変わる以上、テストスイートの品質の測り方も変えなければなりません。さらに、コードカバレッジでは最も重要な問いに答えられなくなります。 テーマ:レガシーマイグレーション · リファクタリング | 対象読者:PM、BrSE、QCリード | 連載:第1回/全2回 サンプル入力 ──▶
マイグレーションテストの進め方|ゴールデンデータと4つの品質軸 続きを読む
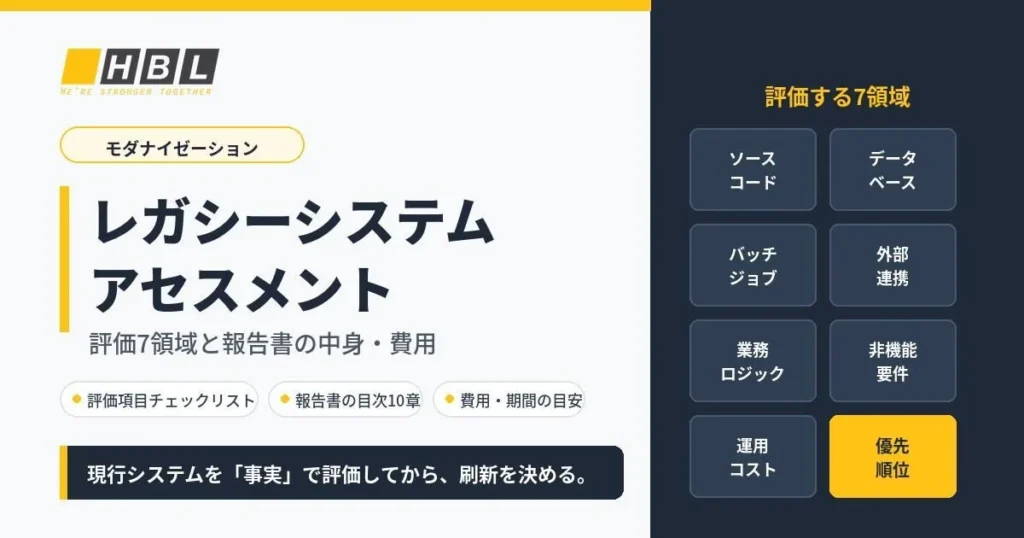
レガシーシステムアセスメントで評価すべき7領域、現行システム調査の進め方、報告書の標準目次、費用と期間の目安、ベンダー選定の基準まで実務ベースで解説します。
レガシーシステムアセスメント|評価7領域と報告書の中身・費用 続きを読む
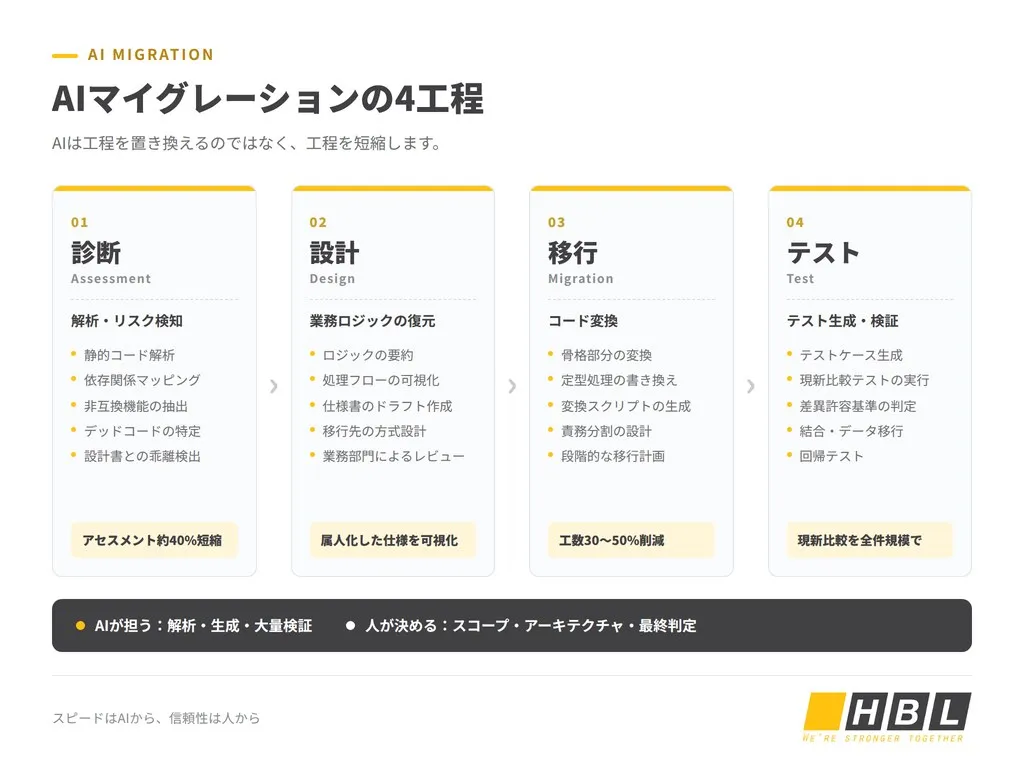
マイグレーションのAI活用が特に効果を発揮するのは、現行資産の解析、業務ロジックの復元と仕様書の生成、そしてテストの生成・検証です。一方で、アーキテクチャの決定、業務ルールの妥当性判断、そして最終的な品質責任は、いまも人が担う領域です。 日本では2030年に約79万人のIT人材が不足するとされ、古い言語を読める技術者はさらに希少になると見込まれます。「AIにコードを読ませる」という選択肢が現実的になったのは、AIが完璧になったからではなく、読める人がいなくなりつつあるからです。 ただし、AIは自信を持って間違えます。請求額が数円ずれる程度の取り違えでも、基幹システムでは重大な事故につながります。本記事では、4工程でAIに任せられる範囲、工数削減が成立する前提条件、ハルシネーションの検知方法、そしてAIと人の責任分界を、実務目線で整理します。 マイグレーションのAI活用とは?——4工程で見る「できることの地図」 AIの話に入る前に、言葉を整理しておきます。マイグレーションとモダナイゼーションを混同したまま議論すると、「AIにどこまで任せられるか」の見積もりもずれてしまうからです。 マイグレーション・モダナイゼーション・リプレースの違い この3つは同じ意味で使われがちですが、投資範囲もリスクの大きさも異なります。 用語 目的 変える対象 代表的な手法 マイグレーション 既存資産を活かしたまま新しい環境へ移す 基盤・言語・インフラ
マイグレーションのAI活用|工程別にできること・限界と品質担保 続きを読む
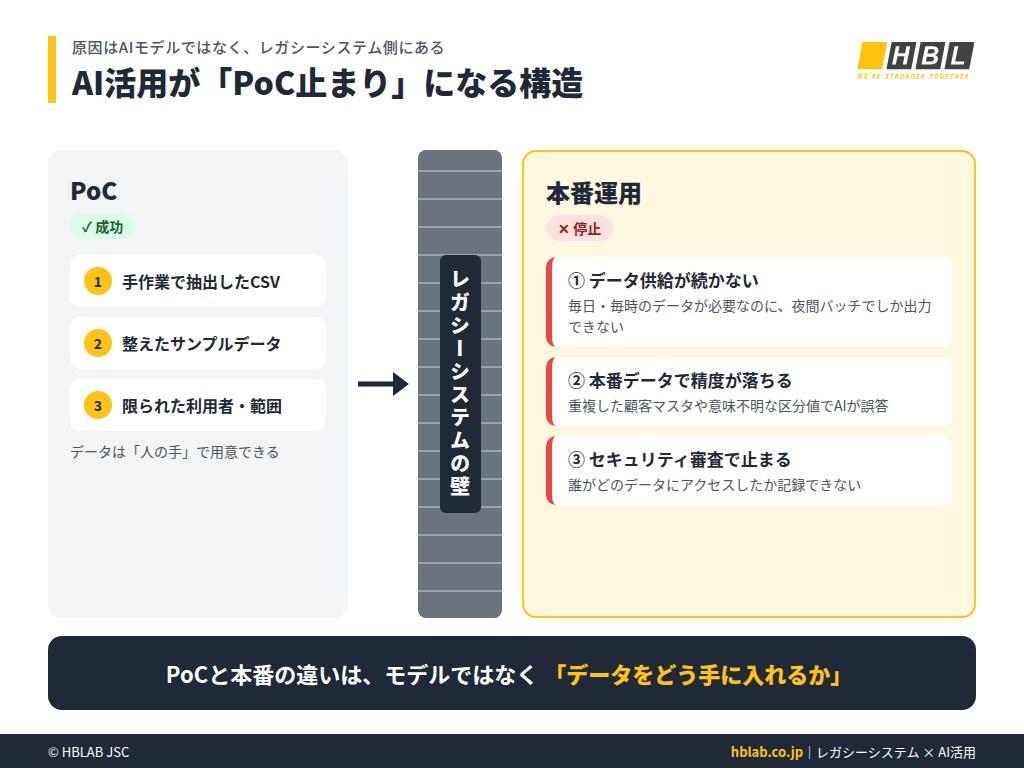
この記事のポイント レガシーシステムがAI活用を阻む原因は、AIモデルではなく「データ層・連携層・ロジック層・ガバナンス層」の4層にあります。AIがPoC止まりになるのは、PoCと本番でデータの扱い方がまったく違うためです。本記事の12項目のチェックで、自社のボトルネックとなっている層を特定できます。全面刷新をしなくても、詰まっている層から順に手を打てば壁は越えられます。 「生成AIを導入したのに、PoCから先に進まない」。その原因の多くは、AIモデルではなくレガシーシステムにあります。レガシーシステムがデータ活用やAI活用の壁になるのは、データが「取り出せない・意味がわからない・つながらない・統制できない」という構造的な問題を抱えているからです。 Gartnerは、AI-readyデータ(AIに適した形で整備されたデータ)の裏付けがないAIプロジェクトの60%が、2026年までに中止されると予測しています(Gartner, 2025年2月)。日本でも経済産業省のレガシーシステムモダン化委員会総括レポートが、約6割の企業にレガシーシステムが残存しており、それが生成AIなど最新技術との連携・組み込みを妨げていると指摘しています。 本記事では、この壁を4つの層に分解し、PoC止まりの構造、AIレディ診断、層別の刷新アプローチ、経営層への説明の仕方までを解説します。レガシーシステム全体のリスクと刷新のタイミングについては、「レガシーシステムのリスク、先延ばしのコスト、そして刷新すべき時期」をご覧ください。レガシーシステムの定義や代表的な課題から確認したい方は、「レガシーシステムとは?定義・最新の解決策と5つの課題」もあわせてご覧ください。 AI活用が「PoC止まり」になる本当の理由は、レガシーシステムにある 多くの企業で、AIのPoC(概念実証)自体は成功します。問題が起こるのは、その成果を本番業務に広げようとした段階です。まずは、よくある失敗パターンから見ていきましょう。 PoCは成功するのに本番で止まる — よくある3つのパターン PoCと本番の違いは、モデルではなく「データをどう手に入れるか」にあります。現場で繰り返し起きているのは、次の3パターンです。 データ供給が続かない:PoCでは、担当者が手作業で抽出したCSVデータで学習させることができます。しかし本番では日次・時間単位で最新のデータが必要になり、夜間バッチでしか出力できないレガシーシステムでは供給が追いつきません。 本番データで精度が落ちる:整えたサンプルデータでは高精度だったモデルが、実データでは重複した顧客マスタや意味が不明な区分値に引きずられ、誤った回答を返し始めます。
なぜレガシーシステムはAI活用の壁になるのか?4層で原因を解剖 続きを読む
レガシーシステムの問題点を技術・データ・コスト・組織の4分類14項目で整理。症状別の見分け方、セルフチェック、影響度×緊急度による優先順位の決め方を解説。
レガシーシステムの問題点|症状別の見分け方と優先順位の決め方 続きを読む
テストはすべて「PASS」。それでも、新しいシステムが業務要件に照らして正しいと言い切れるでしょうか。 この問いは、AIがMigration(マイグレーション)プロジェクトに深く関わり、マイグレーションテストの自動化が進むほど重要になります。レガシーコードのリバースエンジニアリング、ドキュメントの再構築、コード変換、テストケースの生成など、これまで多くの時間を要してきた作業は、AIによってより短時間で処理できるようになっています。生成される成果物が増えるほど、品質の焦点は「どれだけ多く生み出せるか」から「生み出したものが本当に正しく、検証できる根拠を備えているか」へと移ります。 レガシーシステムはベースラインだが、正解そのものとは限らない ドキュメントが不足しているMigrationプロジェクトでは、稼働中のシステムが事実上、重要なベースラインになることが少なくありません。現行の振る舞いを記録する特性化テスト(Characterization Test)も、レガシーシステムの現在の振る舞いを記録し、改修や移行の際に想定外の変化を検知するという考え方に基づいています。 しかし、現状を記述することは、その現状が正しいと保証することとは異なります。レガシーシステムはしばしば複雑な集合体であり、保全すべき中核的なルールと同時に、暫定的な回避策(workaround)、技術的負債(technical debt)、そして当初の理由がすでに不明確になったまま何年も残り続けてきた判断が混在しています。 したがって、移行の品質は、まず期待結果(expected result)を正しく定義できるかどうかに大きく左右されます。この作業では、実際の振る舞い、データ構造、いまも価値のある一部のドキュメント、そして現行の業務要件を突き合わせ、明確な受け入れ基準(acceptance criteria)へと変換していきます。過去の挙動は、その判断材料の一つとして扱います。 そのため、現状評価(Assessment)の工程は、コード行数を数えたり技術スタックを列挙したりする段階にとどまりません。プロジェクトチームは、データフロー、バッチ処理、連携ポイント、依存関係(dependency)、そしてシステムの動作を支える業務ロジックを明らかにし、そのうえで、保全すべき資産、変更してよい領域、管理すべきリスク領域を、移行方式を選択する前に見極める必要があります。 一つの誤りが、AIの連鎖全体に伝播するとき Migrationのスピードは、前工程の出力が次工程の入力へと自動的に引き継がれるときに大きく高まります。ドキュメントはコード生成に用いられ、そのコードと関連ドキュメントは、さらにテストケース生成の土台になります。この構造は工程の多くを自動化しますが、同時にエラー伝播(error propagation)が生じる余地も作り出します。出発点にある一つの誤った前提が、後続の工程へと次々にコピーされていくためです。
AIで加速するMigration。テストが「PASS」でも、それだけでは品質を証明できない理由 続きを読む