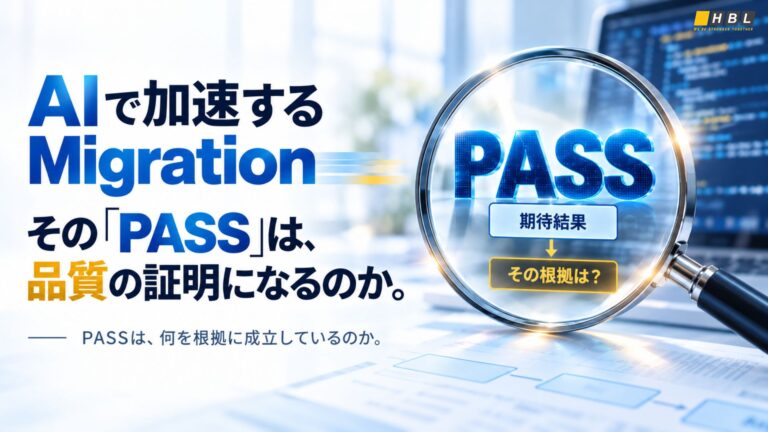
テストはすべて「PASS」。それでも、新しいシステムが業務要件に照らして正しいと言い切れるでしょうか。
この問いは、AIがMigration(マイグレーション)プロジェクトに深く関わり、マイグレーションテストの自動化が進むほど重要になります。レガシーコードのリバースエンジニアリング、ドキュメントの再構築、コード変換、テストケースの生成など、これまで多くの時間を要してきた作業は、AIによってより短時間で処理できるようになっています。生成される成果物が増えるほど、品質の焦点は「どれだけ多く生み出せるか」から「生み出したものが本当に正しく、検証できる根拠を備えているか」へと移ります。
レガシーシステムはベースラインだが、正解そのものとは限らない
ドキュメントが不足しているMigrationプロジェクトでは、稼働中のシステムが事実上、重要なベースラインになることが少なくありません。現行の振る舞いを記録する特性化テスト(Characterization Test)も、レガシーシステムの現在の振る舞いを記録し、改修や移行の際に想定外の変化を検知するという考え方に基づいています。
しかし、現状を記述することは、その現状が正しいと保証することとは異なります。レガシーシステムはしばしば複雑な集合体であり、保全すべき中核的なルールと同時に、暫定的な回避策(workaround)、技術的負債(technical debt)、そして当初の理由がすでに不明確になったまま何年も残り続けてきた判断が混在しています。
したがって、移行の品質は、まず期待結果(expected result)を正しく定義できるかどうかに大きく左右されます。この作業では、実際の振る舞い、データ構造、いまも価値のある一部のドキュメント、そして現行の業務要件を突き合わせ、明確な受け入れ基準(acceptance criteria)へと変換していきます。過去の挙動は、その判断材料の一つとして扱います。
そのため、現状評価(Assessment)の工程は、コード行数を数えたり技術スタックを列挙したりする段階にとどまりません。プロジェクトチームは、データフロー、バッチ処理、連携ポイント、依存関係(dependency)、そしてシステムの動作を支える業務ロジックを明らかにし、そのうえで、保全すべき資産、変更してよい領域、管理すべきリスク領域を、移行方式を選択する前に見極める必要があります。
一つの誤りが、AIの連鎖全体に伝播するとき
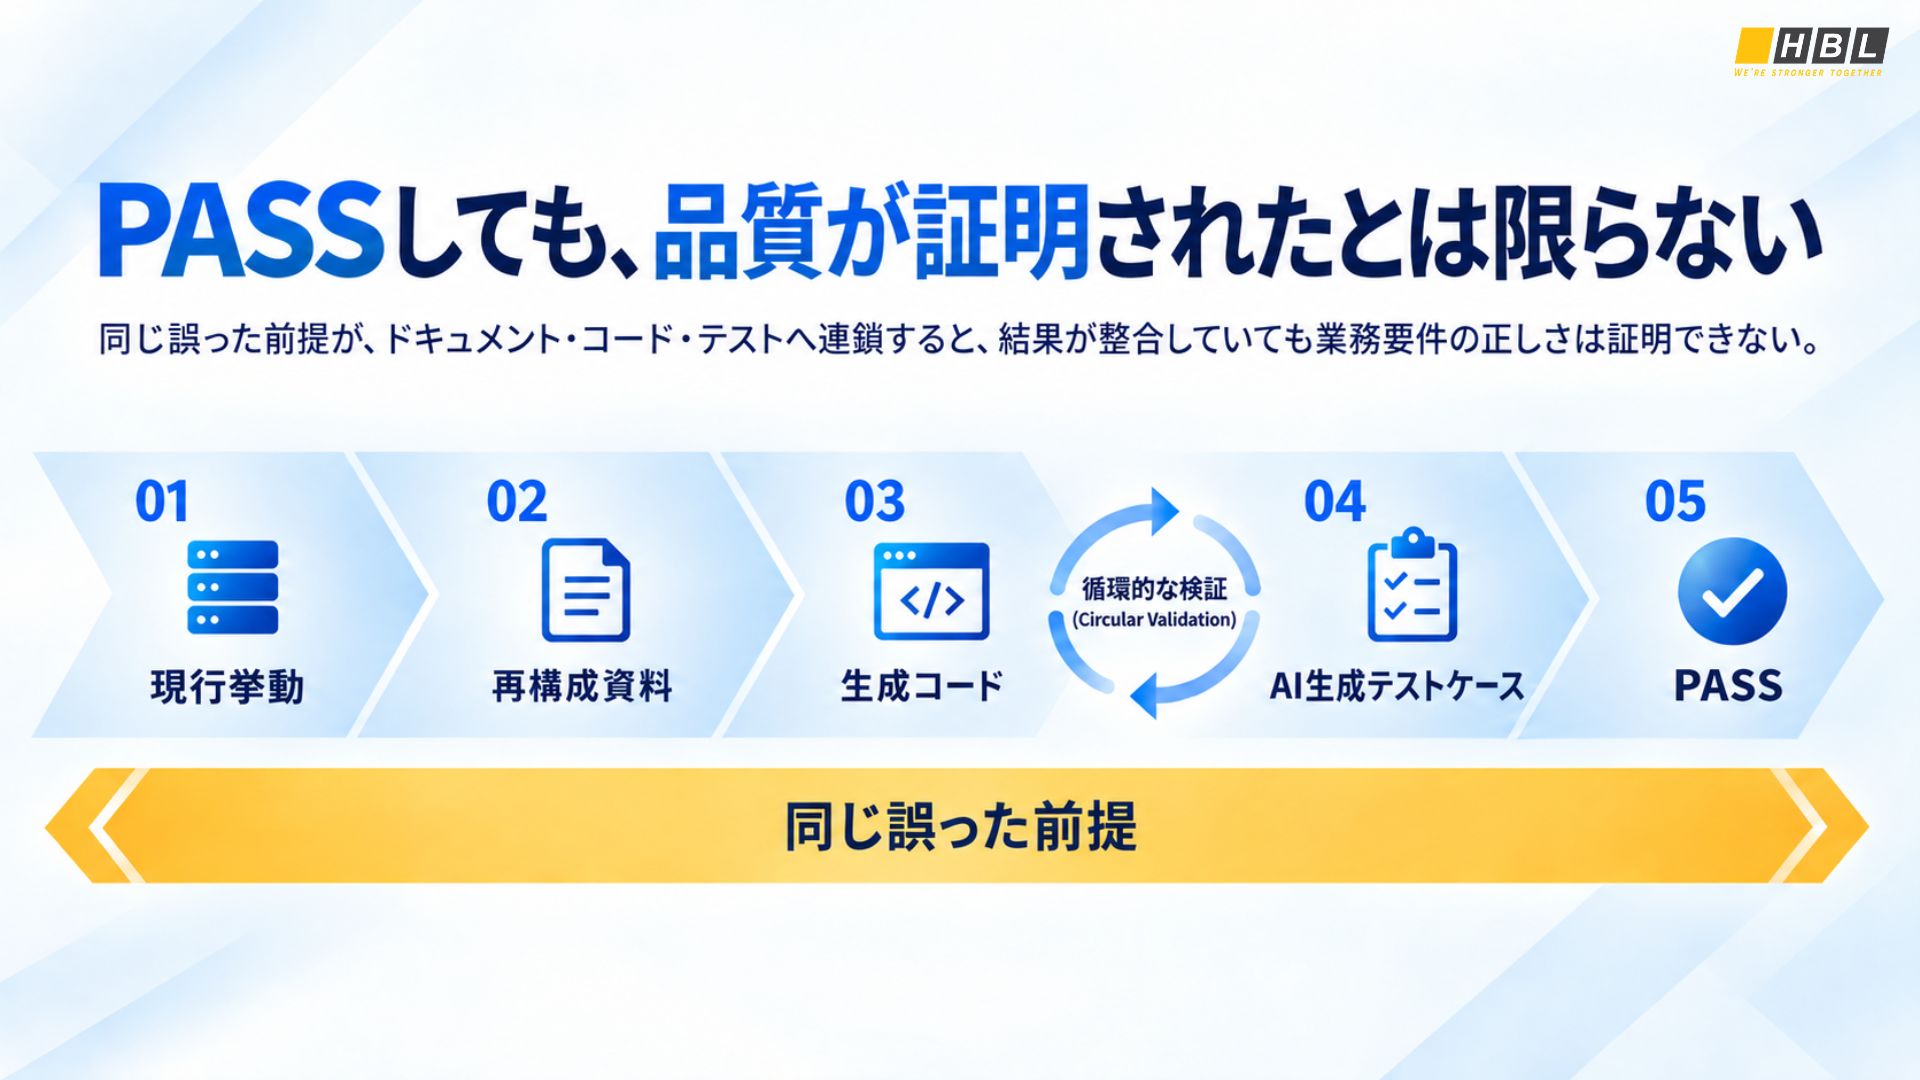
Migrationのスピードは、前工程の出力が次工程の入力へと自動的に引き継がれるときに大きく高まります。ドキュメントはコード生成に用いられ、そのコードと関連ドキュメントは、さらにテストケース生成の土台になります。この構造は工程の多くを自動化しますが、同時にエラー伝播(error propagation)が生じる余地も作り出します。出発点にある一つの誤った前提が、後続の工程へと次々にコピーされていくためです。
コードとテストが同じ誤った前提を引き継いだ場合、プロジェクトはいわば「循環的な検証(circular validation)」の罠に陥る可能性があります。このとき「PASS」という状態は、安全であるかのような錯覚を生みやすくなります。成果物と評価基準は互いに整合していても、両者がそろって当初の業務要件から外れていることがあり得るからです。
このリスクは、実証研究でも観測されています。2026年にプレプリントとして公開された研究では、テストを独立に生成した場合に比べ、誤りを含むコードを先に生成し、その後にテストを生成した場合、不具合の検出効果が25%から14%へ低下したことが報告されています。研究では、生成コード内の誤りが後続のテスト成果物にも再現される現象をerror propagationと呼んでいます。
また、2024年に公開された24件のオープンソースJavaリポジトリを対象とする別の研究では、LLMが生成するテストの正解判定基準、つまりテストオラクル(test oracle)が、プログラムが本来あるべき振る舞いよりも、現在実装されている振る舞いを反映しやすい傾向にあることが示されています。
ISTQB用語集の日本語版でも、テストオラクルは実行結果と比較する期待結果のソースと定義され、「コードであってはならない」とされています。これは、評価対象そのものを期待結果の根拠にしないという本稿の論点とも整合します。
二つの研究が示すのは共通したリスクです。コードとテストが同じ誤った前提を受け継いでいる場合、両者が一致していることだけでは、業務要件に照らした正しさを証明できません。
カバレッジが高くても、最も重要な部分を見落とすことがある
AIが大量のテストケースを生成できるようになると、テストカバレッジ(test coverage)は進捗を示す分かりやすい指標として扱われがちです。しかし、コードが実行されたことと、その処理が業務要件どおりに正しいことは同じではありません。
100%のステートメントカバレッジ(命令網羅/C0)を達成しても、重要なリスクがすべて管理されたとは結論できません。この指標が示すのは、実行可能なステートメントが少なくとも一度は実行されたということです。すべての判定ロジックやブランチカバレッジ(分岐網羅/C1)まで十分に確認されたことを意味するものではありません。
JSTQB Foundation Level v4.0でも、100%のステートメントカバレッジであっても、判定ロジックをすべてテストしていることは確認できず、すべてのブランチを通過していない可能性があると説明されています。
マイグレーションテストでは、金融・会計上の照合ルールや重要な例外処理の分岐が、めったに実行されない数行のコードの中にだけ存在することがあります。テスト戦略がこうした重要領域を最初に特定できていなければ、カバレッジ報告がどれほど高くても、最もリスクの大きい部分を見落としかねません。
カバレッジは、テストがどこまで到達したかという範囲を示します。しかし、実行されたロジックが業務目的に正しく応えているかどうかを判断することはできません。
品質は、テストが始まる前に確立しておく
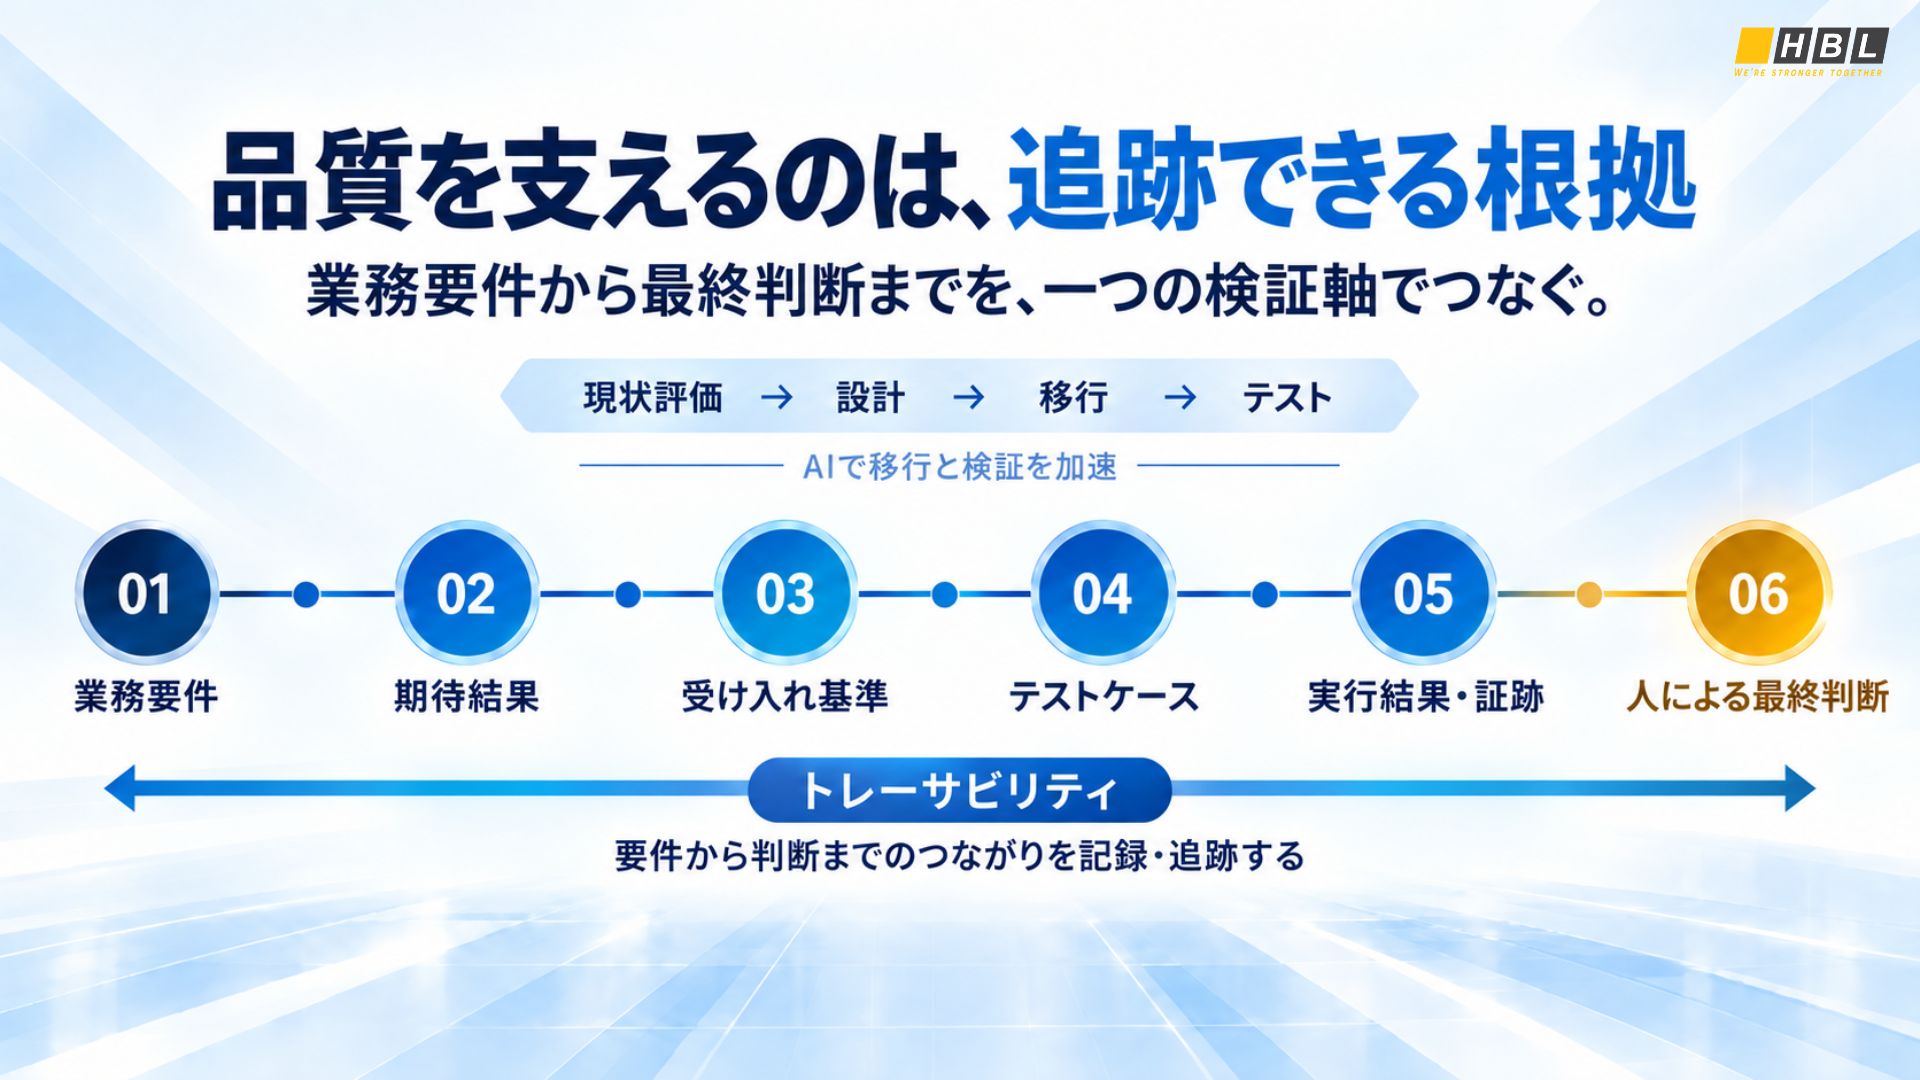
テストの件数やカバレッジが検証プロセスの一断面しか表さない以上、品質を判断する基準は、テストが始まる前から検証戦略の中で明確にしておく必要があります。
検証(Verification)は、システムが定義された要件どおりに作られているかを確認します。妥当性確認(Validation)はさらに、そのシステムが実際の運用ニーズや事業目的に応えているかを確認します。
この二つを切り離さないために、プロジェクトは早い段階で三つの判断軸を明確にしておく必要があります。
レガシーシステムのどの振る舞いを、必ず保全しなければならないか。
どの変更であれば、受け入れてよいか。
どの根拠があれば、受け入れや検収に進めると判断できるか。
この三つを一貫して維持する基盤が、トレーサビリティ(traceability)です。業務要件を受け入れ基準、テストケース、実行結果までつなげておくことで、それぞれのテスト結果がどの業務要件を確認しているのかを追跡できるようになります。
これは、HBLABが取り組むEvidence-led Modernizationの中心にある考え方でもあります。Migrationの全工程を通じて、各段階で次の判断に必要な成果物と根拠を残します。Migureiは自動化できる作業を加速する一方、業務要件の解釈、例外処理、統合、品質評価は、専門家とプロジェクトの責任者が担います。
詳しくは、10月7日のウェビナーで
AIがMigrationの多くの工程に関わるなかで、一貫した検証の仕組みをどう組み立てるのか。HBLABは、実際のケースやMigureiによる実演を交えながら、ウェビナーで具体的に解説します。
日時:2026年10月7日(水)15:00〜16:00(JST)
形式:オンライン/参加無料
AIはMigrationのスピードを大きく引き上げることができます。しかし、移行プロセス全体の品質を左右する問いは、最後まで変わりません。
AIがドキュメント、コード、テストケースまで生成できるいま、その「PASS」が業務要件に照らして本当に正しいと判断するには、AIが生成した一連の成果物そのものに依存しない根拠が必要です。
プロジェクトは、その根拠を持っているでしょうか。