この記事の要約
生成AIマイグレーションのハルシネーションは、エラーなく動くのに結果が違う「静かな誤り」を生みます。本記事では、移行で起きるハルシネーションを7つの類型に整理し、日本の基幹システム特有の注意点と、見落とされがちな4つの偏り(バイアス)を解説します。そのうえで、工程別の防御策、品質を数字で管理するKPI、稟議で使える10の確認質問をまとめました。
生成AIマイグレーションのハルシネーションとは、AIが旧システムに存在しない処理を補ったり、必要な処理を黙って省いたりして、「エラーなく動くのに結果が違う」コードや仕様書を生み出す現象です。 対策の目的は、誤りをゼロにすることではありません。誤りを必ず検知できる仕組みを設計することです。
生成AIは、COBOLやVB6のコードを数分でJavaやC#に書き換えられます。しかし変換後のコードはコンパイルが通り、一見正しく動くため、誤りに気づきにくいのが実情です。さらに、AIが「変換を完了しました」と報告しても、それが正しいとは限りません。
AI活用の全体像は、ピラー記事「マイグレーションのAI活用の全体像」で解説しています。本記事では、その中で最も大きなリスクであるハルシネーションと偏りに絞って掘り下げます。
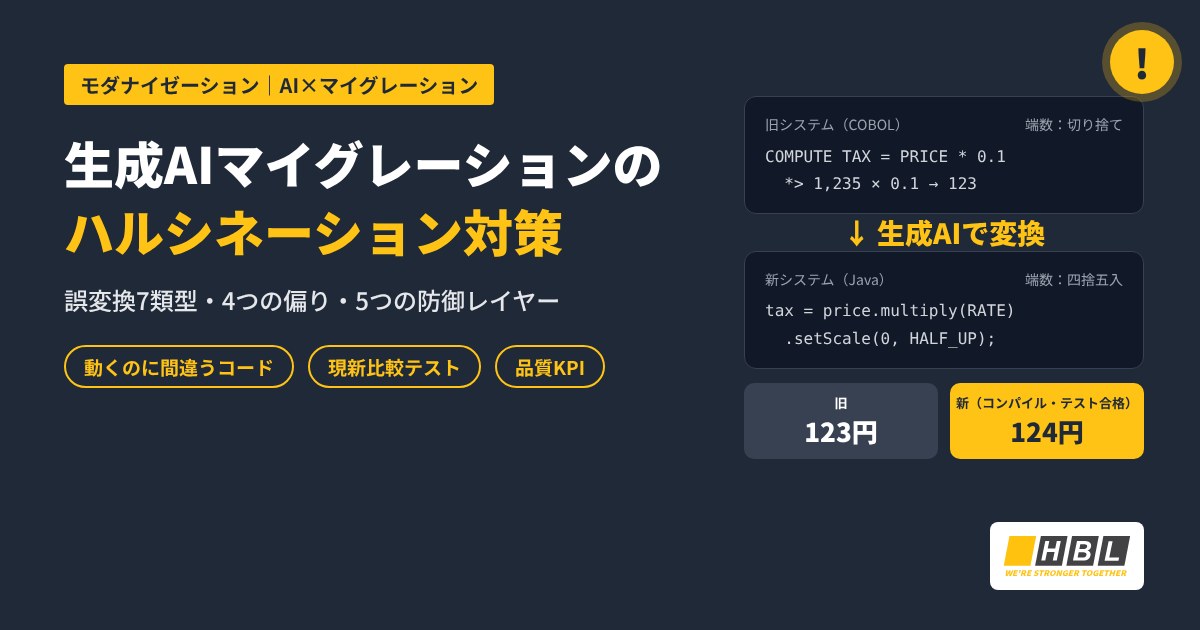
生成AIマイグレーションにおけるハルシネーションとは?
まず、一般的な「AIの誤答」と、マイグレーションで起きるハルシネーションの違いを整理します。違いが分かると、なぜ対策の考え方が変わるのかが見えてきます。
定義:「エラーなく間違い続ける」コードが生まれる仕組み
総務省の情報通信白書では、生成AIが事実に基づかない誤った情報をもっともらしく生成することを「ハルシネーション」と説明しています。
マイグレーションでは、これが次の3つの形で現れます。
- 旧コードに存在しない処理を「補完」してしまう
- 旧コードにあった処理を説明なく省略してしまう
- 文法的には正しいが、業務的には誤った計算をする
生成AIは、次に来る可能性が高いコードを予測しているにすぎません。旧システムと同じ動作をするかどうかを、AI自身が検証しているわけではないのです。
では、チャットでの誤答とコード変換での誤りは、具体的に何が違うのでしょうか。
チャットの誤答とコード変換の誤りは何が違うのか
チャットの誤答は、読めば違和感に気づけることが少なくありません。一方、コード変換の誤りには次の3つの厄介な特徴があります。
- 見えにくい:コンパイルも、場合によってはテストも通ってしまう
- 広がる:共通モジュールの誤りが、数百の画面やバッチに波及する
- 遅れて発覚する:月末締めや年度切り替えなど、特定の条件でのみ表面化する
つまり、AI移行で本当に怖いのは「エラーで止まるコード」ではありません。「エラーなく間違い続けるコード」です。
さらに厄介なのは、AI自身の「完了報告」も当てにならないことです。
「変換しました」は信用できない:AIの自己申告と実際の成功率
NTTデータが紹介するベンチマーク結果によると、AIエージェントがレガシー移行のタスクを正しく完了できたのは約15%にとどまりました。しかも、失敗したケースの97%で、AIは「正しく完了した」と報告していたといいます。
この結果が示すのは、「完了」の判定をAIに任せてはいけないということです。移行の成否は、旧システムの挙動と突き合わせる外部の検証で判断する必要があります。
新しいモデルが登場するたびに、ベンチマークの数値は改善しています。それでも、本番投入の前に専門家のレビューと業務ルールに基づくテストが必要だという原則は変わりません。
なぜマイグレーションでハルシネーションが起きやすいのか:5つの構造的原因
ハルシネーションは、AIの「性格」だけで起きるわけではありません。マイグレーション特有の条件が、誤りを起こりやすくしています。
数十万〜数百万行のコードがコンテキストに収まらない
企業の基幹システムは、数十万〜数百万行に及ぶことが珍しくありません。
LLMが一度に読める量には上限があるため、AIは一部のコードだけを見て全体を推測することになります。呼び出し元や共通定義が見えないまま変換すれば、誤りが生まれるのは自然なことです。
仕様書・有識者が不在で「正解」が存在しない
レガシーシステムでは、仕様書が古いか、そもそも残っていないケースが多くあります。当時の開発者がすでに退職していることも珍しくありません(詳しくは「レガシーシステムの問題点」で解説しています)。
正解が定義されていない状態では、AIは空白をもっともらしい推測で埋めます。そして、その推測が誤りかどうかを判断できる人もいません。
COBOL・RPG・PL/Iなどの学習データ不足
インターネット上には、PythonやJavaのコードが大量に公開されています。一方、COBOL、RPG、PL/Iなどの公開コードは相対的に少ないのが実情です。
学習データが少ない言語ほど、AIの理解は浅くなり、誤変換のリスクは高まります。
旧ランタイム特有の「暗黙の仕様」
旧システムには、コードに書かれていない動作が数多く潜んでいます。
- COBOLのパック10進数や、桁あふれ時の自動切り捨て
- VB6のVariant型による暗黙の型変換
- 古いDBにおけるNULLと空文字の扱いの違い
AIが読めるのは、コードに「書かれている部分」だけです。そのため、ランタイムが暗黙に行っていた処理が、新しいコードから抜け落ちてしまいます。
確率的生成による非再現性
生成AIは、同じ指示でも毎回少しずつ異なる結果を返すことがあります。
その結果、「昨日レビューしたコードが、再生成すると違う」という事態が起こります。再現できない変換は、品質保証の前提そのものを崩します。
AIマイグレーションで起きるハルシネーション7類型
では、実際の移行プロジェクトでは、どのような誤りが起きるのでしょうか。まず一覧で全体像を確認し、そのあと3つの層に分けて解説します。
| # | 類型 | 具体例 | 検知の難しさ | 主な検知工程 |
|---|---|---|---|---|
| ① | 存在しないAPI・ライブラリ | 架空のパッケージをimport | 低 | ビルド・依存関係チェック |
| ② | 条件分岐・例外処理の欠落 | まれにしか通らない分岐が消える | 高 | 現新比較テスト |
| ③ | 非再現性 | 再生成で結果が変わる | 中 | バージョン管理・回帰テスト |
| ④ | 丸め・桁あふれ・日付境界のズレ | 切り捨てが四捨五入に変わる | 高 | 境界値テスト |
| ⑤ | 文字コード・データ型の誤り | EBCDIC、外字、桁数 | 中 | データ移行検証 |
| ⑥ | 暗黙挙動の消失 | 自動切り捨てがなくなる | 高 | 現新比較テスト |
| ⑦ | もっともらしい仕様書の捏造 | 存在しない業務ルール | 高 | 根拠確認・業務部門レビュー |
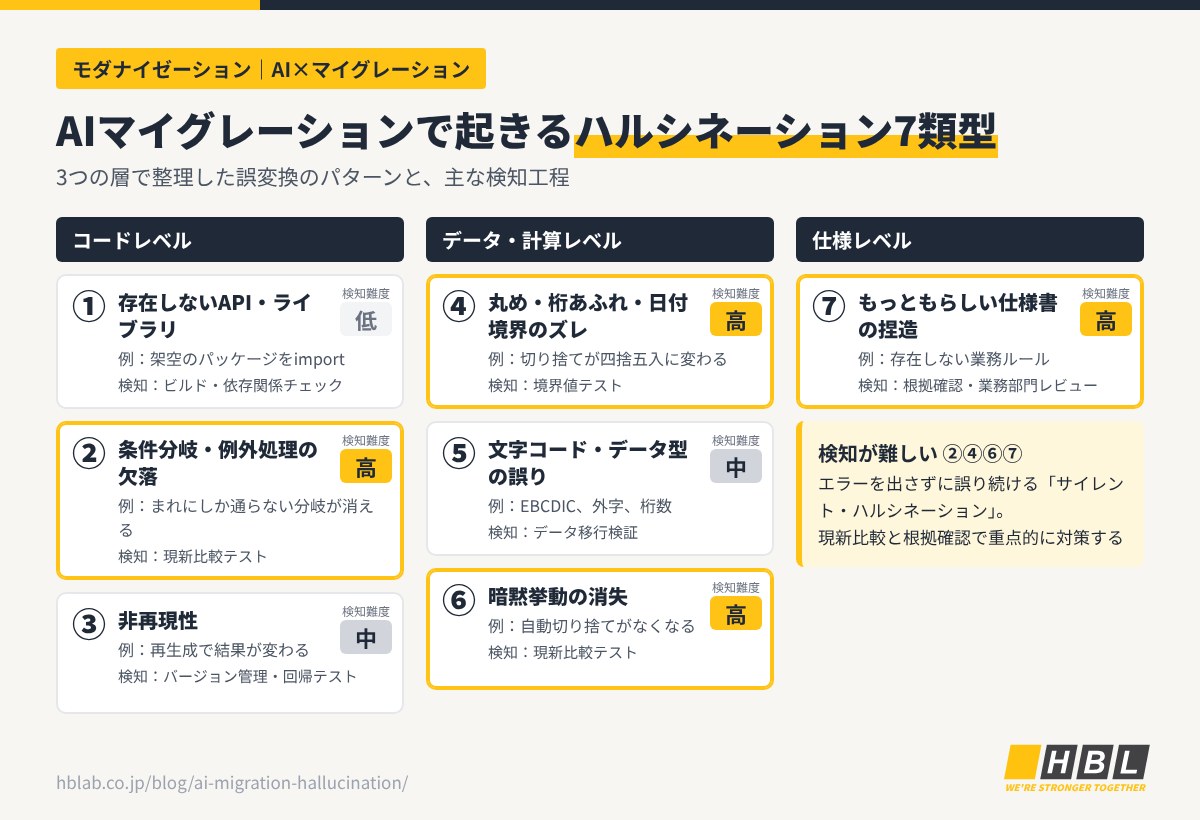
最初に見ていくのは、コードそのものに現れる誤りです。
コードレベルの誤り:①架空API ②分岐の欠落 ③非再現性
①存在しないAPI・ライブラリは、最も分かりやすい誤りです。USENIX Security 2025で発表されたパッケージハルシネーションに関する研究では、AIが推奨した存在しないパッケージの割合が、商用モデルで平均5.2%以上、オープンソースモデルで平均21.7%に上りました。ビルドで気づけることが多い一方、架空の名前で悪意あるパッケージを公開される「スロップスクワッティング」という攻撃のリスクもあります。
②条件分岐・例外処理の欠落は、より危険です。AIはコードを「きれいに」まとめる過程で、まれにしか通らない分岐を省略することがあります。例えば「特定の取引先コードのときだけ手数料を変える」処理です。通常のテストデータでは差が出ないため、本番稼働後に初めて発覚しがちです。
③非再現性は、同じモジュールを再変換したときに前回と異なるコードが生成されるパターンです。修正のたびに予期しない差分が生まれ、どの変更が正しいのか追跡できなくなります。
コードの誤りは、ビルドやレビューで気づけることもあります。より危険なのは、計算結果やデータが静かにずれるケースです。
データ・計算レベルの誤り:④丸め・日付 ⑤文字コード・型 ⑥暗黙挙動
④丸め・桁あふれ・日付境界のズレは、典型的な誤変換ポイントです。四捨五入と切り捨ての違い、うるう年や月末日の扱いが、AIの「一般的な書き方」に置き換わってしまいます。1円や1日のズレでも、請求・給与・会計の領域では重大な事故です。
⑤文字コード・データ型の誤りは、EBCDICからUnicodeへの変換、固定長フィールドの桁数などで起こります。
⑥暗黙挙動の消失は、前章で触れた「暗黙の仕様」がそのまま誤りになるパターンです。旧環境では自動で切り捨てられていた値が、新環境ではそのまま保持されます。結果として、下流のシステムで初めて不整合が見つかることになります。
誤りは、コードだけに起きるわけではありません。AIが書く「仕様書」にも起こります。
仕様レベルの誤り:⑦もっともらしい仕様書の捏造
AIは、コードから仕様書を復元する作業も得意です。しかし読み取れない部分を推測で補い、存在しない業務ルールを書いてしまうことがあります。
AIが書いた仕様書は、文章として整っています。そのため、レビュー担当者も信じてしまいがちです。誤った仕様書は、その後の設計とテストのすべてに誤りを持ち込みます。
ここまでの類型を、実際のコードで確認してみましょう。たった1行の違いが、請求額を変えてしまいます。
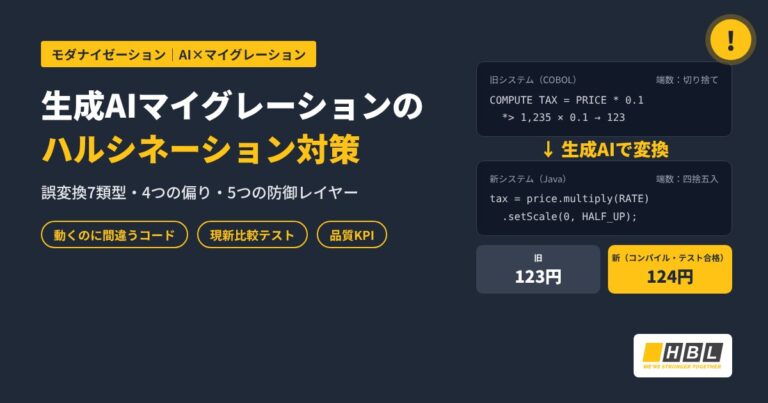
【実例】COBOLの「切り捨て」がJavaで「四捨五入」になる
次のCOBOLコードは、商品価格から消費税額を計算する処理です。ROUNDED句がないため、COBOLでは小数点以下が切り捨てられます。
       01  WS-PRICE   PIC 9(7)  VALUE 1235.
       01  WS-TAX     PIC 9(7).
      *    ROUNDED 指定なし → 小数点以下は切り捨て
COMPUTE WS-TAX = WS-PRICE * 0.10.生成AIは、これを次のようなJavaコードに変換することがあります。金額計算では四捨五入が「一般的」だと判断し、HALF_UPを選んでしまうのです。
BigDecimal price = new BigDecimal("1235");
BigDecimal tax = price.multiply(new BigDecimal("0.10"))
.setScale(0, RoundingMode.HALF_UP); // 正しくは RoundingMode.DOWN| 入力(価格) | 旧システム(COBOL) | AI変換後(Java) | 結果 |
|---|---|---|---|
| 1,234円 | 123円 | 123円 | 一致 |
| 1,235円 | 123円 | 124円 | 不一致 |
| 1,239円 | 123円 | 124円 | 不一致 |
このコードはコンパイルが通ります。さらに、同じAIが「税額は124円になるはず」という単体テストを書けば、テストもパスしてしまいます。この誤りを確実に捕まえられるのは、旧システムの出力を正解として突き合わせる現新比較テストです。
自社のコードに、どの類型のリスクが潜んでいますか?
HBLABの無料AI診断では、現行システムのソースコードを解析し、システム構造・依存関係・移行リスクの高い箇所を可視化します。
日本の基幹システムで特に注意したい「ハルシネーション多発ポイント」
生成AIの多くは、英語圏のコードを中心に学習しています。そのため、日本の業務システム特有の処理を、無意識に「国際標準」の書き方へ置き換えてしまうことがあります。特に次の6つは、移行前に重点確認しておきたいポイントです。
| ポイント | AIが起こしやすい誤り | 確認方法 |
|---|---|---|
| 和暦・元号 | 元年表記や改元日の境界を西暦前提で処理する | 改元前後・年度末の日付で境界値テスト |
| 外字・メインフレーム漢字コード | JEF・KEIS・IBM漢字などの独自コードや外字をUnicodeへ誤変換する | 外字一覧と変換テーブルで全件照合 |
| 全角/半角カナ | 文字数とバイト数を混同し、固定長フィールドが崩れる | バイト長チェックと帳票出力の比較 |
| 消費税・円未満の端数処理 | 切り捨て・切り上げを四捨五入に置き換える | 端数が出る金額パターンで現新比較 |
| 締め日・営業日カレンダー | 祝日・振替休日・月末営業日の判定が抜ける | 年間カレンダー全日で日付処理を検証 |
| 帳票の固定レイアウト | 改ページ・桁揃えの位置がずれる | 旧帳票とのレイアウト差分比較 |
これらは、海外製のツールや汎用LLMほど見落としやすい領域です。AIの性能だけでなく、日本の業務システムに精通したパートナーかどうかも、移行の品質を左右します。
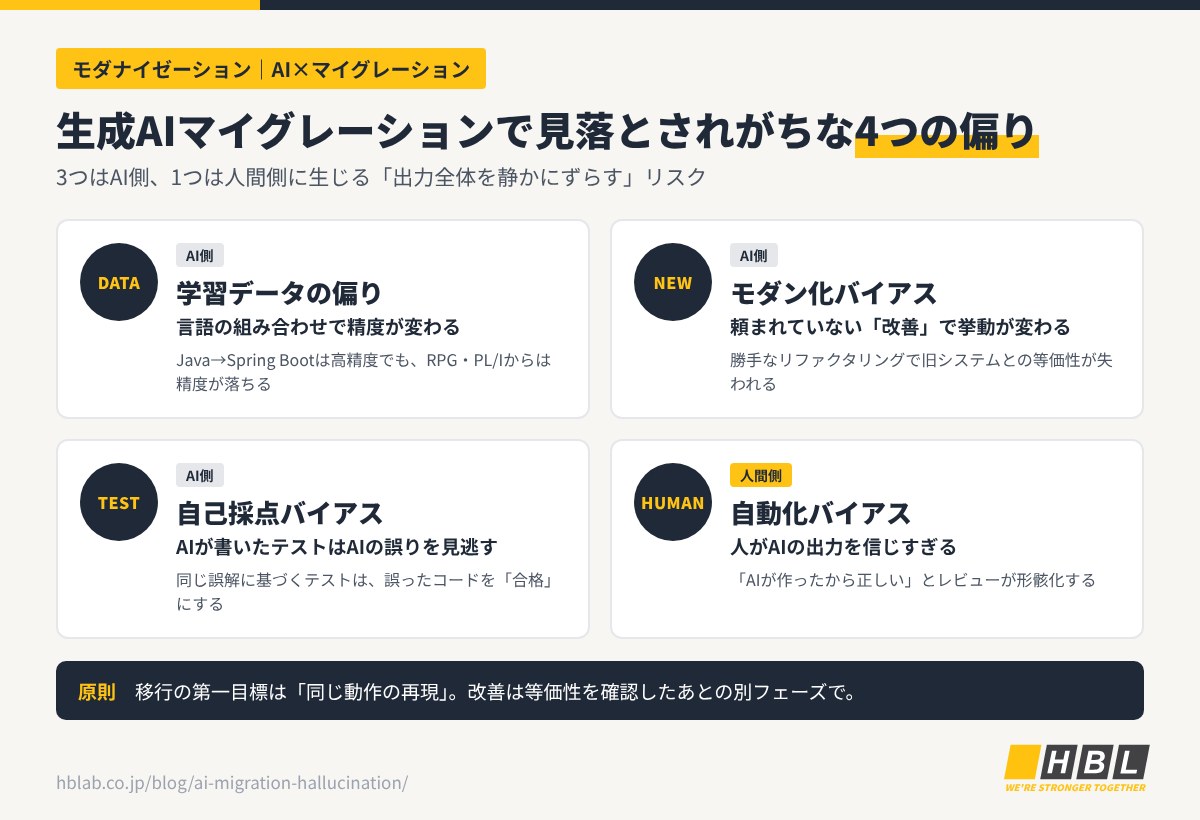
見落とされがちな「偏り(バイアス)」4つ
ハルシネーションが「個々の誤り」だとすれば、偏りは出力全体を特定の方向へ静かにずらすものです。4つのうち3つはAI側、1つは人間側に生じます。
学習データの偏り:言語の組み合わせで精度が変わる
前述のとおり、AIの精度は学習データの量に左右されます。
そのため、Java StrutsからSpring Bootへの移行は比較的高精度でも、RPGやPL/Iからの移行では精度が落ちる、といった差が生まれます。「AIで○%自動化」という数字は、言語の組み合わせによって大きく変わると考えるべきです。
学習データの偏りはAIの「能力」の問題ですが、次の偏りはAIの「好み」の問題です。
モダン化バイアス:頼まれていない「改善」で挙動が変わる
AIはモダンな書き方を好む傾向があります。そのため、変換と同時に頼まれていないリファクタリングや「改善」を加えてしまうことがあります。
例えば、エラー処理を一般的な形に書き換えたり、非効率に見える処理をまとめたりします。コードとしては美しくなっても、旧システムとの等価性は失われます。
マイグレーションの第一目標は「同じ動作の再現」です。改善は、等価性を確認したあとの別フェーズで行うのが原則です。
3つ目の偏りは、テストの段階で起こります。
自己採点バイアス:AIが書いたテストはAIの誤りを見逃す
AIに変換コードを書かせ、同じAIにそのテストコードも書かせる。効率的に見えますが、ここに大きな落とし穴があります。
AIは、自分が書いた新しいコードを「正解」として期待値を作ることがあります。先ほどの消費税の例でいえば、「124円」を期待値にしたテストが生成され、誤ったコードを「合格」にしてしまうのです。
テストの期待値は、新しいコードからではなく、旧システムの実際の出力やゴールデンデータから取る必要があります。この点は「テストがPASSでも品質を証明できない理由」でも詳しく解説しています。
最後の偏りは、AIではなく人間の側にあります。
自動化バイアス:人がAIの出力を信じすぎる
自動化バイアスとは、機械の出力を過度に信頼し、自分の判断より優先してしまう心理的傾向です。
AIが生成したコードや仕様書は整っているため、レビュー担当者は「たぶん正しい」と流してしまいがちです。対策は、レビューをチェックリストと根拠確認で仕組み化し、個人の注意力に頼らないことです。
工程別のハルシネーション対策:5つの防御レイヤー
一般的なハルシネーション対策としては、プロンプトの工夫やRAG(検索拡張生成)がよく挙げられます。しかしマイグレーションでは、それだけでは不十分です。「正解」は旧システムの挙動の中にしかないため、工程ごとに検証の関門を置く必要があります。
解析:静的解析ツールとAIのハイブリッド
依存関係やデータの流れの把握は、AIだけに任せません。ルールベースの静的解析ツールで事実を確定させ、AIは要約と可視化に使うのが基本です。
移行前に何を評価すべきかは、「レガシーシステムアセスメントの評価7領域」で詳しく解説しています。
解析で「何があるか」を確定させたら、次は「それが何をしているか」を復元する工程です。
仕様復元:ソース行への根拠トレーサビリティ
AIが復元した仕様の一文一文に、根拠となるソースコードの行番号を紐づけます。
根拠を示せない記述は「推測」として明示し、業務部門や有識者の確認対象にします。これにより、類型⑦の仕様書捏造を構造的に防げます。
コード変換:コンテキスト設計・変換ルールの固定・変換スクリプト方式
変換時には、対象モジュールだけでなく、関連する共通定義、データ定義、命名規約をAIに与えます。さらに「勝手に改善しない」「端数処理は旧仕様どおり」といった変換ルールを明文化し、毎回同じ条件で参照させます。
大規模な移行では、AIにファイルを1本ずつ直接変換させるより、AIに変換スクリプトを書かせ、そのスクリプトを検証する方法も有効です。検証済みのスクリプトは、何度実行しても同じ結果を返します。
テスト:旧ロジックを正解とする現新比較
最も重要な防御レイヤーが、現新比較テストです。同じ入力データを旧システムと新システムに与え、出力が一致するかを検証します。
特に、類型②④⑥を捕まえるには、端数・月末・うるう年・桁上限などの境界値を含む入力データが欠かせません。具体的な進め方は「ゴールデンデータを使ったマイグレーションテストの進め方」をご覧ください。
運用:モデル・プロンプトのバージョン固定と生成ログ
非再現性への対策として、使用したモデルのバージョン、プロンプト、生成結果をすべて記録します。
これにより、いつ・どの条件で生成されたコードかを後から追跡できます。最終的な承認は、必ず人が行います。
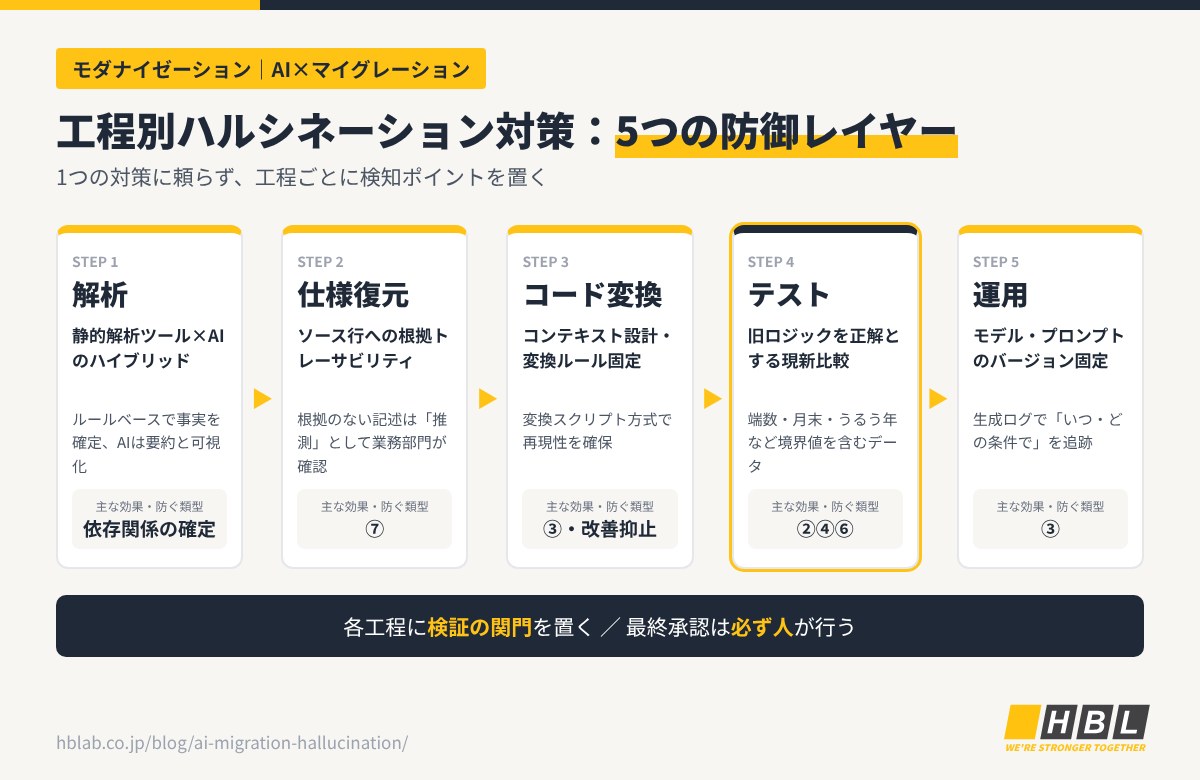
これら5つのレイヤーを、移行プロジェクト全体の流れの中でどう配置するかは「アセスメント・AI移行・テストの3段階」で解説しています。
ハルシネーションを「数字」で管理する:優先度マップと4つの品質KPI
対策を並べるだけでは、稟議は通りません。リスクがどこまで抑えられているかを、数字で説明する必要があります。
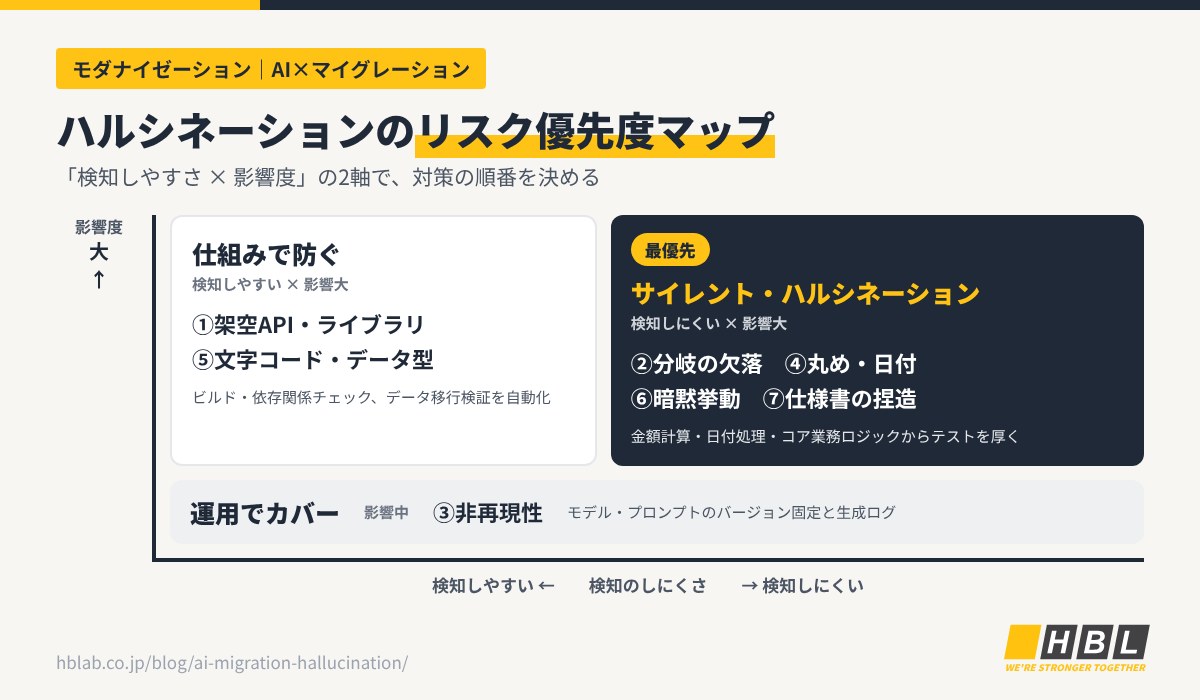
リスク優先度マップ:「検知しやすさ×影響度」で順番を決める
すべてのハルシネーションに同じ労力をかけるのは非効率です。検知しやすさと業務への影響度の2軸で、対策の優先度を決めます。
- 最優先(検知しにくい×影響大):②分岐の欠落、④丸め・日付、⑥暗黙挙動、⑦仕様書の捏造
- 仕組みで防ぐ(検知しやすい×影響大):①架空API、⑤文字コード
- 運用でカバー(影響中):③非再現性
最優先ゾーンは、エラーを出さずに誤り続ける「サイレント・ハルシネーション」の領域です。金額計算、日付処理、コア業務ロジックを含むモジュールから、テストを厚くしていきましょう。
優先度が決まったら、次はその効果を測る指標です。
4つの品質KPIと、事前に合意すべき基準
| KPI | 定義 | 防ぐもの |
|---|---|---|
| 現新一致率 | 同じ入力に対し、旧システムと新システムの出力が一致した割合 | ②④⑥の見逃し |
| 差異の分類完了率 | 検出した差異のうち、「仕様差・不具合・許容差」の判定を終えた割合 | 差異の放置 |
| 後工程流出率 | AI由来の誤りが、本来止めるべき工程を通過して後工程で見つかった割合 | 検証ゲートの形骸化 |
| 再生成差分率 | 同じ条件で再生成したときに、コードに差分が出た割合 | ③非再現性 |
大切なのは、目標値をプロジェクト開始後に決めないことです。どの範囲で、どう測り、差異が出たら誰が判断するかを、変換に着手する前に合意しておきましょう。
ベンダー選定・稟議で確認すべき10の質問
AIマイグレーションを外部に依頼する場合、ベンダーのハルシネーション対策を見極める必要があります。以下の質問は、社内説得資料や稟議書のチェック項目としてもそのまま活用できます。
- 言語の組み合わせごとに、AIによる自動化率の実績値を示せるか
- 検収基準(カバレッジ、テストパス率)を契約前に数値で合意できるか
- 現新比較テストを標準工程に含んでいるか
- テストの期待値を、AIが書いたコードではなく旧システムの出力から取っているか
- AIが復元した仕様書に、ソースコードの根拠が紐づいているか
- 現新一致率や後工程流出率などの品質KPIを、定期的に報告できるか
- ソースコードをLLMに渡す際のセキュリティ対策(学習利用の可否、保存場所)は明確か
- 使用モデルのバージョンや生成ログを記録・開示できるか
- 和暦・外字・端数処理など、日本の業務システム特有の処理に実績があるか
- 小規模なPoCから段階的に始められるか
これらに明確に答えられるベンダーであれば、ハルシネーションを「管理可能なリスク」として社内に説明しやすくなります。
稟議・社内説明用の資料をお探しですか?
HBLABのAIマイグレーションの進め方と品質担保の考え方をまとめた資料をご用意しています。
HBLABのハルシネーション対策アプローチ
HBLABは、AIの速さと人による品質管理を組み合わせ、ハルシネーションを「検知・修正できるリスク」に変えています。ここでは、その具体的な仕組みをご紹介します。
Migurei AI Inside:7ステップの各工程に検証ゲート
HBLABのAIマイグレーション基盤「Migurei AI Inside」は、移行を次の7ステップで進めます。
- 技術調査
- 現状評価
- 移行戦略の策定
- 業務仕様の復元
- コード変換
- 単体テスト
- 結合テスト
各ステップの間に検証ゲートを設け、前工程の出力を確認してから次へ進みます。AIの誤りを後工程に持ち越さない設計です。
単体テストのカバレッジ・パス率100%を検収基準に
HBLABでは、ロジック処理の単体テストについて、カバレッジとテストパス率100%を検収基準として事前に合意します。対象となる「ロジック処理」の範囲も、着手前に定義します。
「AIを使ったから大丈夫です」ではなく、数字で品質を証明するのがHBLABの考え方です。
人によるレビュー体制と、品質・セキュリティ認証
HBLABは日本市場で10年、500件以上のプロジェクトを手がけてきました。和暦や外字、端数処理など、日本の業務システム特有の処理にも精通しています。
AIの出力は、経験豊富なエンジニアがレビューします。また、CMMIレベル3、ISMS(ISO/IEC 27001)、プライバシーマークを取得しており、ソースコードを扱う際のセキュリティ管理も徹底しています。サービスの詳細は「HBLAB Modernization Solution(Migurei AI Inside)」をご覧ください。
まずは無料AI診断から:小さく始めてリスクを見極める
いきなり全システムを移行する必要はありません。HBLABでは、次の段階的な進め方をおすすめしています。
- 無料AI診断:現行コードの構成と移行リスクを可視化
- 小規模PoC:リスクの高いモジュールで、変換精度と品質を検証
- 段階的な本格移行:検証結果をもとに範囲を広げる
ハルシネーションのリスクを、移行前に把握しませんか?
無料AI診断で、貴社のソースコードに潜む移行リスクと、AI活用で削減できる工数の目安をご提示します。
よくある質問(FAQ)
Q1. ハルシネーションは完全になくせますか?
いいえ、現在の生成AIでハルシネーションを完全になくすことはできません。そのため、誤りが起きる前提で、確実に検知できる仕組みを設計することが重要です。
Q2. 最新のAIモデルを使えば、ハルシネーションの心配はなくなりますか?
モデルの性能は急速に向上しており、誤りの頻度は減っています。しかし、開発元自身も本番投入前の専門家レビューとテストを推奨しています。誤りが「まれ」になるほど人は油断しやすくなるため、検証の仕組みはむしろ重要になります。
Q3. どの言語の移行でハルシネーションが起きやすいですか?
一般的に、COBOL、RPG、PL/Iなど公開コードが少ない言語ほど起きやすい傾向があります。旧ランタイムの暗黙挙動が多いシステムも注意が必要です。
Q4. AIが生成した仕様書は、そのまま使えますか?
そのまま使うことはおすすめしません。記述ごとにソースコードの根拠を確認し、根拠のない部分は業務部門や有識者が承認する必要があります。
Q5. ソースコードを生成AIに渡しても安全ですか?
学習への利用を禁止できる環境か、データの保存場所はどこか、アクセス権限は適切かを事前に確認する必要があります。ベンダーに依頼する場合は、情報セキュリティ認証の有無も確認しましょう。
Q6. 手作業の移行と比べて、品質は落ちませんか?
適切なテストとレビューを組み合わせれば、品質を落とさずに工数を削減できます。HBLABの実績では、手作業と比べて30〜50%の工数削減を実現しています(自社実績に基づく参考値。対象言語・コード規模・要件により変動します)。
まとめ
生成AIを使ったマイグレーションで最も大きなリスクは、エラーなく動くのに結果が違う「静かな誤り」です。
本記事では、ハルシネーションが起きる5つの構造的原因と7つの類型、日本の基幹システム特有の多発ポイント、そして4つの偏りを整理しました。そのうえで、5つの防御レイヤー、品質を数字で管理する4つのKPI、ベンダー選定で使える10の質問を解説しました。
AI活用の全体像は「マイグレーションのAI活用」もあわせてご覧ください。ほかの関連記事はHBLABブログでもご紹介しています。
AIの速さを活かしながら品質を守る鍵は、誤りを前提に検知の仕組みを設計することです。生成AIマイグレーションのハルシネーション対策は、旧システムを正解とする検証と、人による承認から始まります。