この記事の要約
AIリバースエンジニアリングは、静的解析と生成AI(LLM)を組み合わせ、レガシーシステムのソースコードから設計書や業務ルールを復元する手法です。人手の解析より速く進められますが、コードの外にある運用ルールや設計意図までは復元できません。本記事では、AIで復元できる成果物と限界、精度を数字で検証する方法、進め方の6ステップ、法務上の注意点を解説します。
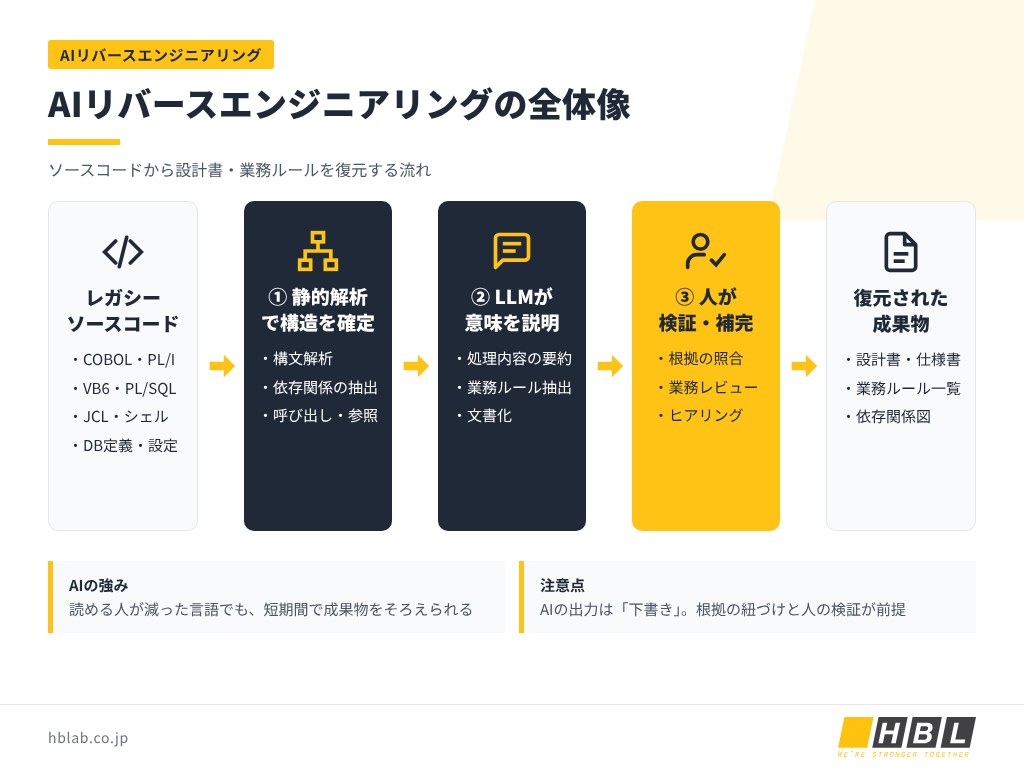
AIリバースエンジニアリングとは、AIを使ってレガシーシステムのソースコードを読み解き、失われた設計書・仕様書・業務ルールを復元する取り組みです。
具体的には、構文解析や依存関係の抽出といった静的解析で「構造」を押さえ、そのうえで大規模言語モデル(LLM)が処理の意味を自然言語で説明します。COBOLやVB6のように読める技術者が減っている言語でも、プログラム一覧・依存関係図・業務ルール一覧といった成果物を短期間でそろえられるのが強みです。
一方で、AIの出力はそのまま「正解」にはなりません。根拠となるソース行への紐づけ、解析カバレッジの可視化、業務担当者のレビューを組み合わせて、初めて移行や保守の判断に使える資料になります。
AIリバースエンジニアリングとは?従来の解析手法との違い
リバースエンジニアリングそのものは新しい技術ではありません。変わったのは、「誰が・どこまで・どの速さで」コードを読むかです。
定義:ソースコードから設計書・業務ルールを復元する技術
ソフトウェアのリバースエンジニアリングは、完成したプログラムを調べて、その構造や仕様を明らかにする作業です。レガシーシステムの文脈では、「設計書がない」「設計書が現行コードと合っていない」システムの仕様を取り戻すことが主な目的になります。
AIリバースエンジニアリングでは、このうち「コードを読んで意味を説明する」部分をAIが担います。人がゼロから読むのではなく、AIが下書きを作り、人が検証する分業に変わるのです。
では、従来の手法と比べて具体的に何が変わるのでしょうか。
人手・静的解析ツール・AIの比較
| 観点 | 人手による解析 | 静的解析ツール | AIリバースエンジニアリング |
|---|---|---|---|
| 速度 | 遅い(担当者のスキルに依存) | 速い | 速い |
| 構造の把握(依存関係・呼び出し) | 漏れが出やすい | 得意 | 得意(静的解析と併用) |
| 業務ロジックの説明 | 得意(ただし属人的) | 苦手(構造のみ) | 得意(要検証) |
| 成果物の形式 | 担当者ごとにばらつく | 図・一覧が中心 | 文章・図・表を統一形式で生成 |
| 主な弱点 | 時間と人材の不足 | 「なぜ」が分からない | ハルシネーション、コード外の情報 |
ポイントは、AIが静的解析ツールを置き換えるのではないことです。静的解析が作った「地図」に、AIが意味を書き込むと考えると分かりやすいでしょう。
レガシーシステムアセスメントの中での位置づけ
AIリバースエンジニアリングは、単独のプロジェクトとして行うより、レガシーシステムアセスメント(評価7領域と進め方)の一工程として実施するのが効果的です。特に「①ソースコード:規模・複雑度・デッドコード」と「⑤業務ロジックと仕様の復元性」の調査を大きく短縮できます。
目的を「ドキュメントを作ること」ではなく「判断に必要な情報をそろえること」に置くと、解析範囲を絞り込みやすくなります。
なぜ今、レガシーシステムにAIリバースエンジニアリングが必要なのか
多くの企業がレガシーシステムの刷新を検討しながら、なかなか着手できずにいます。その背景には、共通する3つの事情があります。
設計書と現行コードが一致しない「ドキュメント負債」
長年運用されたシステムでは、改修のたびに設計書を更新する運用が守られていないことが珍しくありません。その結果、「設計書はあるが信用できない」状態が生まれます。
この状態では、改修の影響範囲を設計書から見積もれず、毎回コードを読み直すことになります。症状の見分け方はレガシーシステムの問題点と見分け方でも整理しています。
COBOL・PL/I・VB6を読める技術者の引退と属人化
COBOLやPL/I、VB6で書かれたシステムでは、開発当時の担当者の引退とともに「読める人」が減り続けています。仕様が特定の担当者の頭の中にしかない状態は、システムのブラックボックス化と属人化の典型例です。
経済産業省のDXレポート(2018年)は、ブラックボックス化した既存システムが残った場合の経済損失を、2025年以降で最大12兆円/年と試算しました。さらにIPAのレガシーシステムモダン化委員会は、産業界のレガシーシステム脱却の進捗が「依然としてスピード感に欠ける」と指摘しています。
移行の失敗は「理解不足」から始まる
移行プロジェクトがつまずく原因は、新しい技術の選定ミスよりも、現行システムを正しく理解しないまま進めることにあるケースが多く見られます。隠れた業務ルールを見落としたまま移行すると、本番稼働後に不具合として表面化します。
AIリバースエンジニアリングは、この「理解」の工程を短縮し、移行判断の前提をそろえるための手段です。
自社コードの「ブラックボックス度」を、まず把握しませんか
HBLABの無償AI診断なら、ソースコードをZIPでアップロードするだけ。構造・依存関係・移行難易度をまとめた診断レポートを、24時間以内にメールでお届けします。
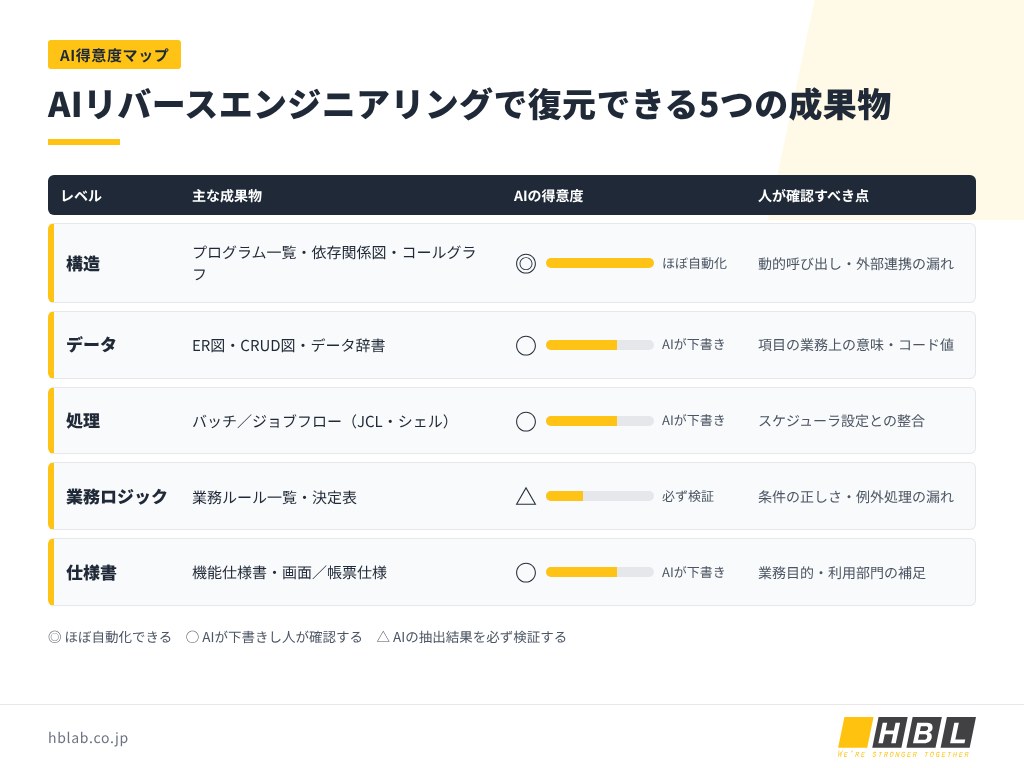
AIリバースエンジニアリングで復元できる成果物【AI得意度マップ】
「設計書を復元する」と一言で言っても、成果物の種類によってAIの得意・不得意は大きく異なります。ここでは成果物を5つのレベルに分けて整理します。
構造レベル:プログラム一覧・依存関係図・コールグラフ
AIリバースエンジニアリングが最も得意とする領域です。プログラム同士の呼び出し関係、共通モジュールの利用箇所、COBOLのコピー句の参照関係などは、静的解析で機械的に抽出できます。
AIはこの結果を要約し、「どのプログラムが中心的な役割を担っているか」を説明する形で補います。
構造が見えたら、次はその構造の中を流れるデータです。
データレベル:ER図・CRUD図・データ辞書
テーブル定義やSQL、ファイルレイアウトから、ER図やCRUD図(どのプログラムがどのデータを作成・参照・更新・削除するか)を作成できます。
ただし、項目名が略称やコード値のままの場合、AIが付ける意味の説明には推測が含まれます。データ辞書は業務担当者の確認が欠かせません。
処理レベル:バッチ/ジョブフロー(JCL・シェル)
JCLやシェルスクリプトを解析すれば、ジョブの実行順序や入出力ファイルの流れを図にできます。
一方で、実行タイミングや一部の条件はジョブスケジューラ側の設定に書かれていることが多く、コードだけでは全体像がそろわない点に注意が必要です。
業務ロジックレベル:業務ルール一覧・決定表
「この条件のときに割引率を変える」といった業務ルールを、コードの分岐から抽出し、一覧や決定表にまとめます。AIの価値が最も大きい一方で、誤りが最も起きやすい領域でもあります。
仕様書レベル:機能仕様書・画面/帳票仕様
上記4つの成果物を統合し、機能単位の仕様書や画面・帳票の仕様書として整えます。形式の統一や文章化はAIが得意ですが、「この機能は業務上なぜ必要か」という説明には人の補足が必要です。
| レベル | 主な成果物 | AIの得意度 | 人が確認すべきポイント |
|---|---|---|---|
| 構造 | プログラム一覧、依存関係図、コールグラフ | ◎ | 動的な呼び出し・外部連携の漏れ |
| データ | ER図、CRUD図、データ辞書 | ○ | 項目の業務上の意味、コード値の定義 |
| 処理 | ジョブフロー、入出力関連図 | ○ | スケジューラ設定・運用手順との整合 |
| 業務ロジック | 業務ルール一覧、決定表 | △ | 条件の正しさ、例外処理の漏れ |
| 仕様書 | 機能仕様書、画面・帳票仕様 | ○ | 業務目的・利用部門の補足 |
※◎=ほぼ自動化できる/○=AIが下書きし人が確認する/△=AIの抽出結果を必ず検証する
AIリバースエンジニアリングの仕組み — 静的解析×LLMのハイブリッド
成果物の品質は、AIをどのように組み込むかで決まります。ここでは、実務で使われる仕組みを分解して見ていきます。
なぜLLM単体では不十分なのか
汎用のチャット型AIにソースコードを貼り付ければ、それらしい説明は返ってきます。しかし、数十万〜数百万行規模のシステムでは、一度に読み込める量(コンテキスト長)を超えてしまいます。
また、LLMは存在しない処理をもっともらしく説明するハルシネーションを起こすことがあります。どの工程で起きやすいかは、マイグレーションのAI活用(できること・限界)で詳しく解説しています。
だからこそ、構造は静的解析で確定させ、LLMには「意味の説明」を任せる設計が重要になります。
解析パイプラインの6段階
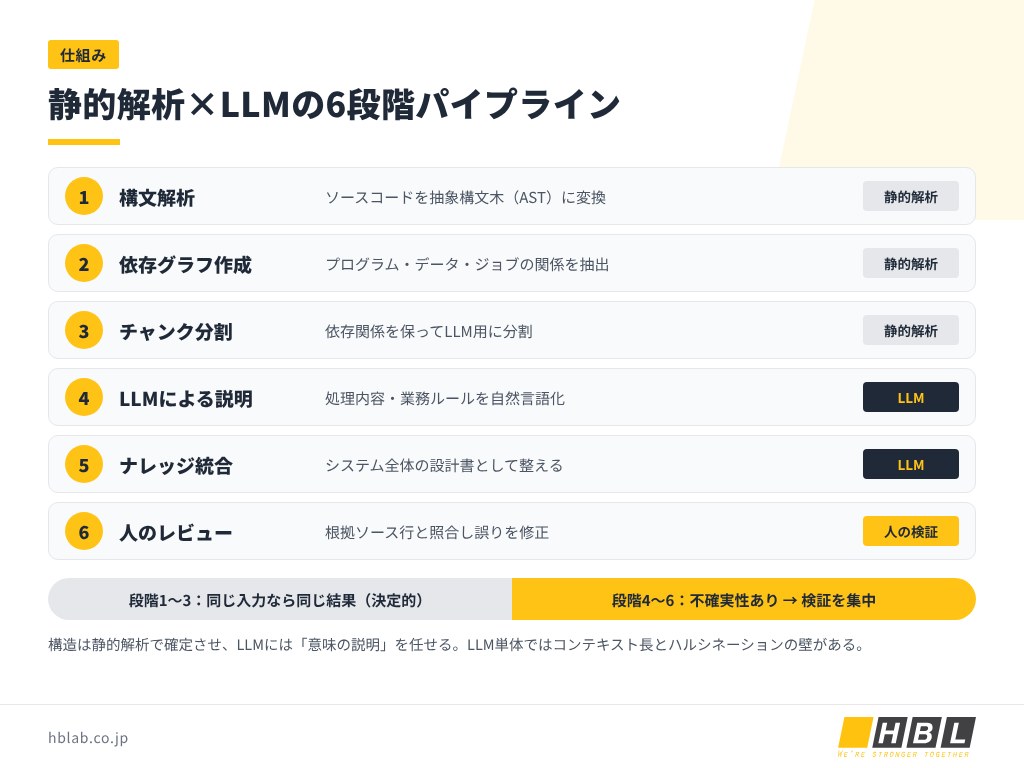
実務的なAIリバースエンジニアリングは、次の6段階で進みます。
- 構文解析:ソースコードを抽象構文木(AST)に変換し、文法レベルで構造を把握する
- 依存グラフの作成:プログラム・データ・ジョブ間の呼び出しと参照の関係を抽出する
- チャンク分割:依存関係を保ったまま、LLMが扱える単位にコードを分割する
- LLMによる要約・説明:各チャンクの処理内容や業務ルールを自然言語で説明する
- ナレッジ統合:チャンク単位の説明を統合し、システム全体の設計書として整える
- 人のレビュー:根拠のソース行と照らし合わせ、誤りや漏れを修正する
段階1〜3は決定的な処理で、同じ入力からは同じ結果が得られます。不確実性が生じるのは段階4以降のため、検証の工数もここに集中させます。
仕組みを理解したところで、実際に使われるアプローチの違いも押さえておきましょう。
アプローチの種類:汎用LLM・コーディングエージェント・専用サービス
- 汎用LLM(チャット型):小さなプログラムの理解には手軽だが、大規模システム全体の整合性は保ちにくい
- コーディングエージェント:リポジトリ全体を探索しながら解析できるが、成果物の形式や検証の仕組みは自前で用意する必要がある
- 専用プラットフォーム/サービス:静的解析・LLM・成果物テンプレート・レビュー工程が一体になっており、大規模なレガシーシステムに向いている
どれを選ぶ場合も、ソースコードが学習に使われないか、どこで処理されるかは必ず確認してください。
AIでも復元できない仕様 — コードの外にある5つの情報
AIリバースエンジニアリングが読めるのは、渡されたコードと設定だけです。しかし、実際のシステムの振る舞いは、コードの外にある情報にも左右されます。
運用でカバーしている暗黙のルール
「月末はこの画面を使わない」「このエラーが出たら手作業で再実行する」といった運用ルールは、コードには書かれていません。システムの不備を運用で補っている部分は、ヒアリングでしか見つかりません。
ジョブスケジューラ・DBトリガー・設定ファイルに散らばるロジック
実行条件はジョブスケジューラに、整合性チェックはDBのトリガーやストアドプロシージャに、分岐の閾値は設定ファイルに、というようにロジックは分散しています。解析対象に含める資産の範囲を最初に決めることが重要です。
期末・年次だけ動く処理と「デッドコード」の見分け方
静的解析では、呼び出し元が見つからないコードを「デッドコード」と判定することがあります。しかし、その中に決算期や年度替わりだけ使われる処理が含まれていることもあります。
削除を判断するのは、1年分以上の実行ログと突き合わせてからにするのが安全です。
外部システムとの暗黙の取り決め
連携先とのファイル形式、送信タイミング、エラー時の扱いは、相手側との取り決めで決まっていることがあります。自社のコードだけを見ても、その前提は分かりません。
「なぜそうなっているか」という設計意図
コードは「何をしているか」は教えてくれますが、「なぜそうしたか」は教えてくれません。法令対応や過去の障害対策として入れた処理を、意図を知らずに削ってしまうのは典型的な失敗です。
これらを補うには、実行ログの分析と業務担当者へのヒアリングを組み合わせます。具体的な3ステップは、レガシーシステムアセスメントにおけるリバースエンジニアリングの実務を参照してください。
AIの解析結果をどう検証するか — 精度を数字で示す4つの方法
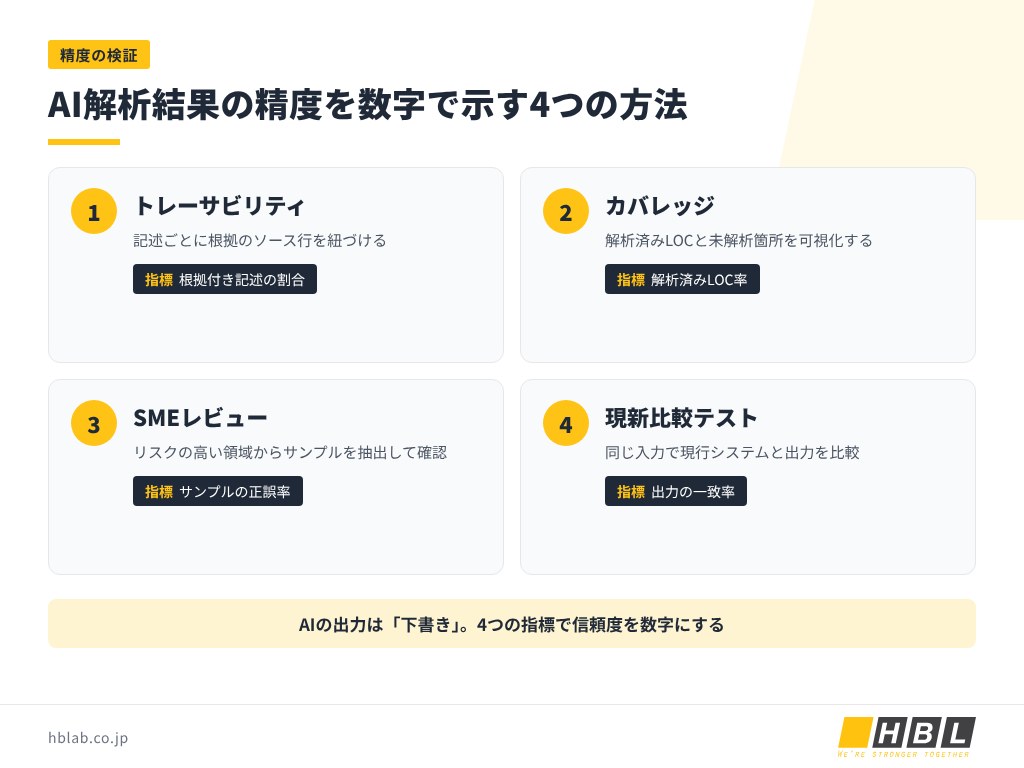
AIが作った設計書を社内の判断材料にするには、「どれくらい信用できるのか」を説明できなければなりません。ここでは、精度を数字で示すための4つの方法を紹介します。
トレーサビリティ:記述ごとに根拠のソース行を紐づける
設計書の各記述に、「どのファイルの何行目に基づくか」を紐づけます。根拠のない記述はAIの推測として区別できるため、レビュー担当者は確認すべき箇所に集中できます。
カバレッジ:解析済みLOCと未解析箇所を可視化する
全体のコード行数(LOC)のうち、どれだけを解析し、どれだけが未解析・解析不能だったかを示します。「すべて解析しました」ではなく、「何%を解析し、残りはなぜ未解析なのか」を報告できる状態が理想です。
業務担当者(SME)レビューのサンプリング設計
すべての業務ルールを人が確認するのは現実的ではありません。金額計算や締め処理など、リスクの高い領域から優先してサンプルを抽出し、正誤率を記録します。
正誤率が基準を下回った領域は、範囲を広げて再確認します。
現新比較テストで「復元した仕様=実際の動作」を確かめる
最も確実な検証は、復元した仕様どおりに動くかを実データで確かめることです。現行システムと同じ入力を与え、出力が一致するかを比較します。ゴールデンデータを使った具体的な進め方は、マイグレーションテストの進め方で解説しています。
研究分野でも同じ考え方が見られます。2026年に公開された研究「Reversa」では、COBOLで書かれたATMシステムのGo言語への移行を題材に、レガシーコードから517件の主張(claims)と53件の同等性検証シナリオを作成しています。ただし同研究も最終的な同等性検証は未完了としており、実務では検証まで含めて計画する必要があります。
なお、テストが「PASS」しても品質を証明しきれない理由については、AIで加速するMigrationと品質の考え方も参考になります。
AIリバースエンジニアリングの進め方 — 6ステップと期間の目安
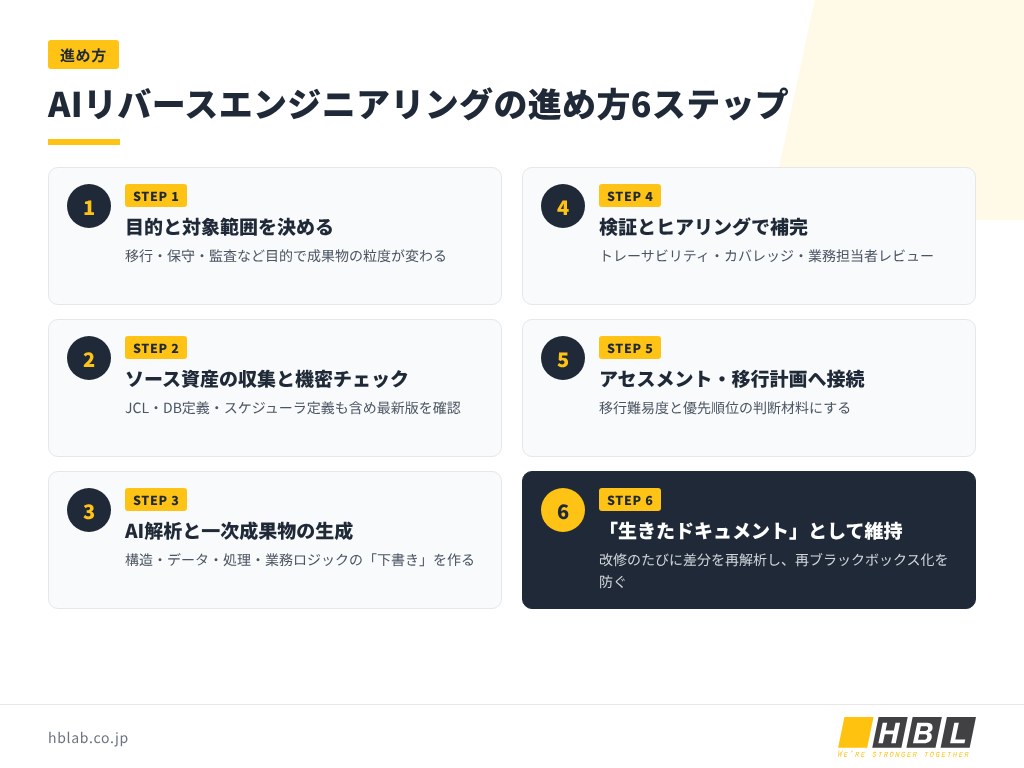
ここからは、AIリバースエンジニアリングを実際に進める手順を6つのステップで紹介します。
STEP 1:目的と対象範囲を決める
最初に「何のために復元するのか」を決めます。移行のため、保守の引き継ぎのため、監査対応のためなど、目的によって必要な成果物の粒度は変わります。
目的が曖昧なまま全量を解析すると、使われない資料が大量に生まれてしまいます。
STEP 2:ソース資産の収集と機密情報チェック
ソースコードに加え、JCL、シェル、DB定義、設定ファイル、ジョブスケジューラの定義も集めます。本番環境と一致する最新版かどうかの確認も欠かせません。
外部のAIに渡す前には、認証情報や個人情報が含まれていないかを確認します。チェック項目はソースコードをLLMに渡す前に確認すべき項目にまとめています。
STEP 3:AI解析と一次成果物の生成
前述のパイプラインで解析を実行し、構造・データ・処理・業務ロジックの一次成果物を生成します。この段階の成果物は、あくまで「下書き」と位置づけます。
STEP 4:検証とヒアリングによる補完
トレーサビリティとカバレッジを確認し、業務担当者のレビューで業務ルールの正誤を確かめます。コードの外にある情報は、ヒアリングと実行ログで補います。
STEP 5:アセスメント報告書・移行計画へつなぐ
復元した成果物を、移行難易度や優先順位の判断に活用します。報告書に何が書かれているべきかはアセスメントレポートが答えるべき10の問い、着手順の決め方はモダナイゼーションの優先順位と範囲の決め方を参照してください。
STEP 6:一回で終わらせない — 「生きたドキュメント」として維持する
復元した設計書は、次の改修が入った瞬間から古くなり始めます。改修のたびに差分を再解析し、ドキュメントを更新する運用を決めておくことで、システムが再びブラックボックス化するのを防げます。
期間を左右する5つの変数
| 変数 | 期間への影響 |
|---|---|
| コード規模(LOC) | 規模に応じて解析・レビューの工数が増える |
| 言語・方言の種類 | 複数言語の混在や独自の方言があると前処理が増える |
| 既存ドキュメントの有無 | 少ないほどヒアリングと検証の比重が上がる |
| 業務担当者の参加度 | レビューの回答速度が全体の期間を左右する |
| 求める成果物の粒度 | 仕様書レベルまで求めるほど検証工数が増える |
いきなり全体を対象にするのではなく、まず一部のモジュールで試して精度と工数の感覚をつかみ、全体に広げる進め方が安全です。
ZIPをアップロードするだけで、移行難易度が分かります
HBLABの無償AI診断では、.java/.cs/.vb/.cblなどのソースコードを解析し、構造・依存関係・移行難易度をまとめた12〜18ページのレポートをお届けします。事前の打ち合わせやお見積もりは不要です。
法務・セキュリティの注意点 — 自社システムでも確認すべき4項目
「自社のシステムだから自由に解析してよい」と考えがちですが、事前に確認しておきたい点がいくつかあります。
※本章は一般的な情報の紹介です。個別の判断は、法務部門や専門家にご確認ください。
著作権法第30条の4と「プログラムの調査解析」
平成30年の著作権法改正(2019年1月1日施行)で、第30条の4が整備されました。文化庁による改正法の解説では、権利制限の対象となる例として「プログラムの調査解析を目的としてプログラムの著作物を利用する行為(いわゆる「リバース・エンジニアリング」)」が挙げられています。
SIerが開発したシステムの権利帰属と契約の確認
レガシーシステムの多くは、SIerなど外部の開発会社が構築しています。開発委託契約の内容によっては、プログラムの著作権が委託先に残っている場合もあります。
解析そのものに加え、解析結果をもとに改修・移行する際の扱いも含めて、契約書の権利帰属条項を確認しておくと安心です。現在の保守ベンダーと早めに情報を共有しておくことも、後のトラブル防止につながります。
パッケージ製品・ミドルウェアのライセンス
自社開発の部分とは別に、パッケージ製品やミドルウェアの使用許諾契約で解析が制限されていることがあります。解析対象から外すか、提供元に確認しましょう。
ソースコードを外部AIに渡すときのデータ管理
ソースコードには、業務ノウハウや顧客情報の扱い方が含まれています。外部のAIサービスや委託先に渡す場合は、次の点を確認してください。
- 入力したデータがAIモデルの学習に使われないか
- 処理後のデータがいつ削除されるか
- 通信や保管が暗号化されているか
- NDAを締結できるか、ISMSなどの認証を取得しているか
内製か外部委託か — 判断基準とベンダーに聞くべき5つの質問
AIリバースエンジニアリングは、ツールを導入して内製で進めることも、専門の会社に委託することもできます。判断の目安は次のとおりです。
| 判断基準 | 内製が向くケース | 外部委託が向くケース |
|---|---|---|
| コード規模 | 一部のモジュールに限定 | 数十万行以上、システム全体 |
| 言語 | 社内に読める人がいる | COBOL・PL/Iなど読める人がいない |
| 成果物の検証 | 社内で検証できる | 検証できる人材が不足している |
| 期限 | 余裕がある | 移行判断の期限が迫っている |
| 目的 | 日常的な保守の改善 | 移行・刷新の判断材料づくり |
外部に委託する場合は、次の5つを必ず確認してください。
- 成果物の各記述に、根拠となるソース行が紐づいているか
- 解析カバレッジと未解析箇所を、どのように報告するか
- 業務ルールのレビューは誰が、どの言語で行うか
- ソースコードは学習に使われず、いつ削除されるか
- 成果物を移行やテストの工程でそのまま再利用できるか
ベンダー選定の全体像は、モダナイゼーションベンダーの選び方(8つの評価基準)で詳しく解説しています。
HBLABのAIリバースエンジニアリング支援
HBLABは、Modernization Solution(Migurei AI Inside)を通じて、レガシーシステムの解析から移行・テストまでを支援しています。
AI × BA/SA の二層体制:AIが解析し、人が検証する
AIが構造解析と業務ロジックの抽出を行い、BA(ビジネスアナリスト)とSA(システムアナリスト)が成果物を検証します。AIの速さと人の判断を組み合わせることで、スピードと信頼性を両立します。
解析から移行・テストまで一貫して対応
HBLABのAI Assessment Toolは、技術調査・評価・移行戦略・業務仕様の文書化・コード変換・単体テスト・結合テストの7工程をカバーしています。リバースエンジニアリングで復元した仕様を、そのまま移行とテストの基準として使えるのが特長です。
日本語で業務を聞ける体制と情報管理
日本語で業務担当者にヒアリングできる体制を整えています。また、ISMS(ISO/IEC 27001)とプライバシーマークを取得しています。無償AI診断でお預かりしたファイルは提出から3日以内に自動削除され、AIモデルの学習に使われることはありません。
レガシーシステムの「読めないコード」を、まず可視化しませんか
設計書がない、担当者がいない──そんなシステムこそ、最初の一歩は現状の把握から。
関連する記事はモダナイゼーション関連記事一覧からご覧いただけます。
よくあるご質問
Q1. AIリバースエンジニアリングは違法ではありませんか?
著作権法第30条の4では、プログラムの調査解析(いわゆるリバース・エンジニアリング)が、権利制限の対象となる例として挙げられています。ただし、委託開発の契約内容やパッケージ製品のライセンスによって制限がある場合もあるため、事前に確認してください。
Q2. ソースコードが一部しか残っていない場合でも解析できますか?
残っている部分から解析を始めることは可能です。HBLABの無償AI診断も、モジュールの一部だけのアップロードに対応しています。ソースが失われた部分は、実行ログや画面・帳票、業務ヒアリングから仕様を補います。
Q3. COBOL以外の言語にも対応できますか?
AIリバースエンジニアリングの手法自体は、VB6、PL/SQL、古いバージョンのJavaや.NETなど、多くの言語に適用できます。HBLABの無償AI診断では、.java/.cs/.vb/.cblなどのファイルを推奨形式としています。
Q4. チャット型AIにソースを直接貼るのと何が違いますか?
チャット型AIでは、大規模なシステム全体の依存関係を保ったまま解析することが難しく、根拠となるソース行の紐づけもできません。また、入力したコードの扱いについて、社内規程との整合にも注意が必要です。
Q5. 解析にはどれくらいの期間がかかりますか?
コード規模、言語の種類、既存ドキュメントの有無、求める成果物の粒度によって変わります。まずは無償AI診断で規模と移行難易度を把握し、そのうえで計画を立てるのが確実です。
Q6. 生成した設計書は、その後の保守にも使えますか?
使えます。ただし改修のたびに古くなるため、差分を再解析して更新する運用をあわせて決めておくことをおすすめします。
まとめ
- AIリバースエンジニアリングは、静的解析とLLMを組み合わせて、レガシーシステムの設計書・業務ルールを復元する手法
- 構造・データ・処理・業務ロジック・仕様書の5レベルで、AIの得意度は異なる
- 運用ルールや設計意図など、コードの外にある情報はログ分析とヒアリングで補う
- トレーサビリティ・カバレッジ・SMEレビュー・現新比較テストで、精度を数字で示す
- 権利帰属やデータ管理など、法務・セキュリティの確認も欠かせない
アセスメント全体の進め方は、レガシーシステムアセスメントもあわせてご覧ください。設計書のないシステムでも、検証の仕組みと組み合わせれば、AIリバースエンジニアリングは移行判断を支える確かな手段になります。